品牌出海东南亚,买家会直接问 ChatGPT、Gemini、Perplexity、Claude 和 Google AI 概览。看清它们怎么介绍你,又读了哪些来源。
每次扫描都把买家真正会问的问题——用他们的语言,覆盖购买的每个阶段——拿去问 ChatGPT、Gemini、Perplexity、Claude,以及实时的 Google AI 概览页面。面板保持冻结,所以分数变了,就是 AI 变了,而不是题目变了。

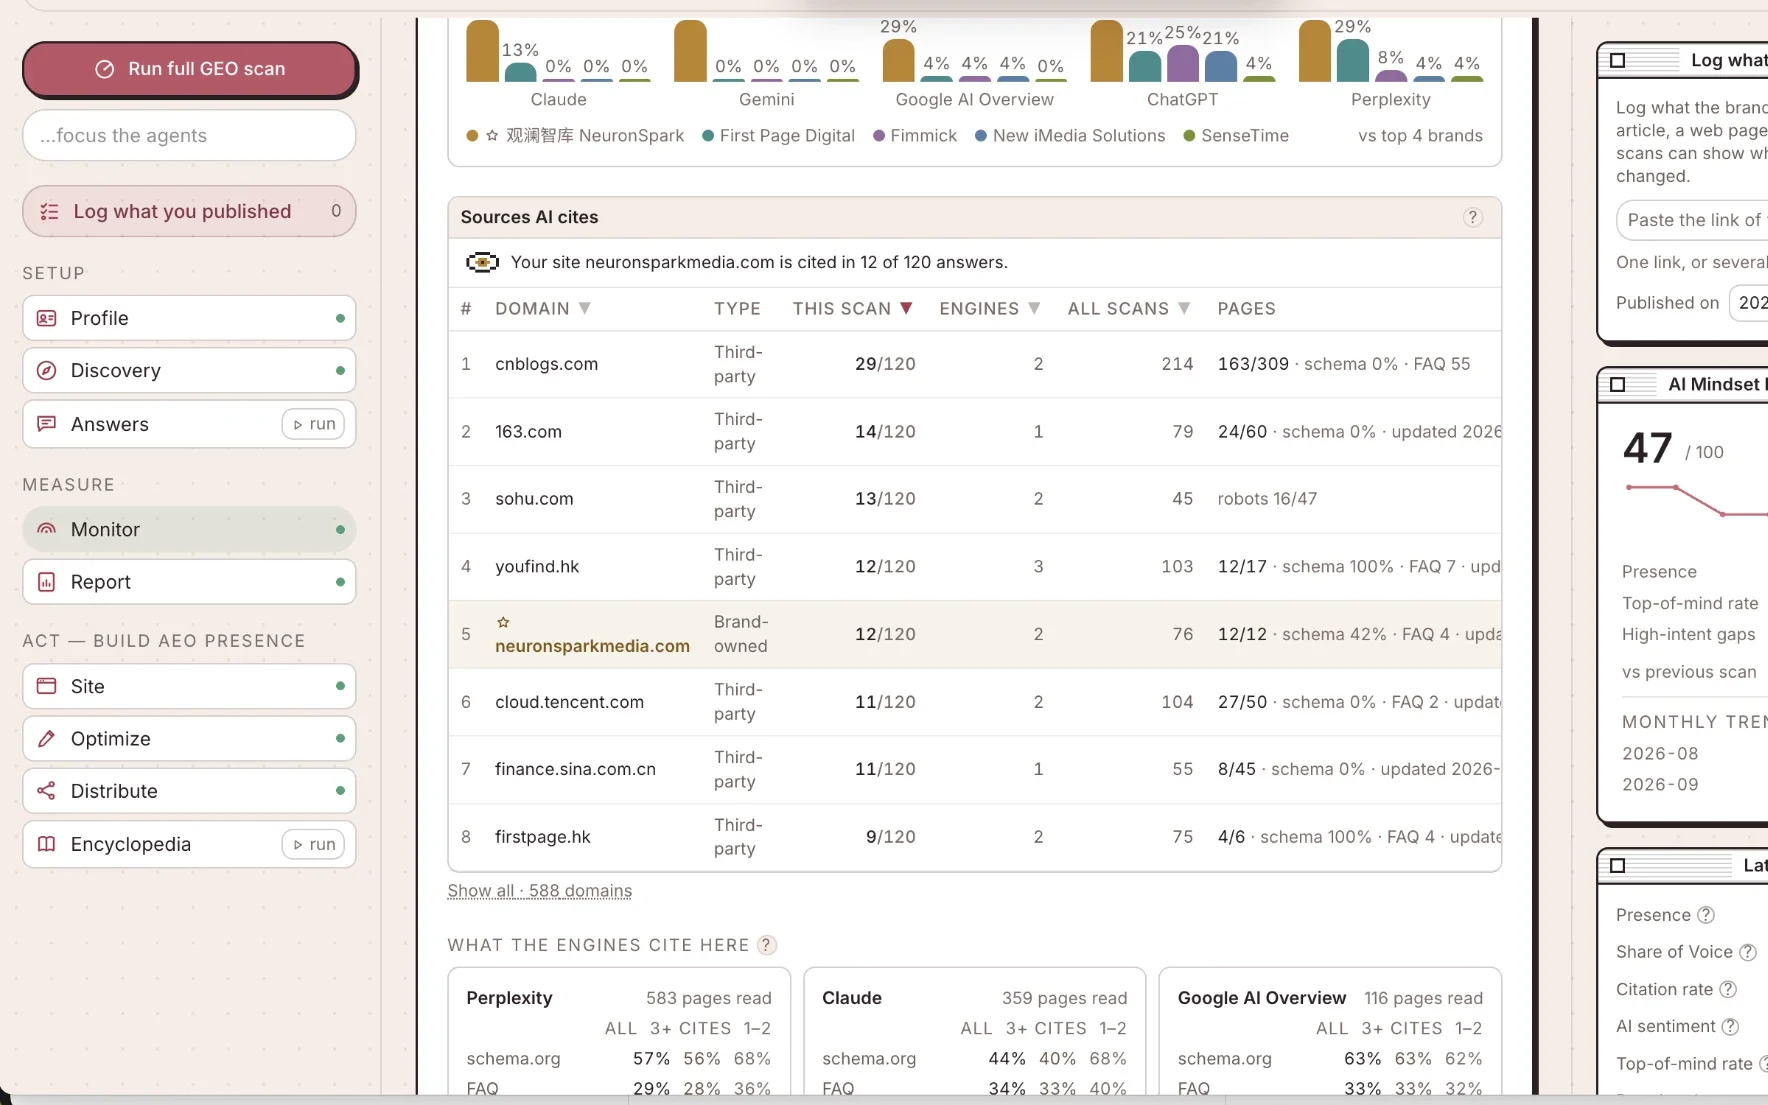
在每个市场,引擎都依赖一小批网站。我们跨所有扫描为这些网站排名,抓取它们被引用的页面并做画像——结构、时效、schema、篇幅——让「什么样的页面会被引用」成为你写内容时对照的实测标准,而不是凭感觉。

标准答案、页面修改、可直接粘贴的 schema、缺口内容、投放包和百科草稿——用买家的语言,按你所在市场的引用画像来写,只取材于你官网上已公开的事实。没有出处的数字会留成空白由你填写,绝不编造。

记录已上线的内容。我们抓取页面、生成内容指纹,并观察引擎是否开始使用它。之后的扫描会显示哪些变了——按问题、按引擎——并与你没有动过的问题放在一起对照。

并不是每个引擎都会读网页。我们按扫描本身显示的结果为每个引擎归类——它的回答中有多少附带来源——因为影响它们的因素各不相同。
回答由实时抓取的页面组成,其中也包括你的页面。你自己的页面、结构化数据和内容时效,最先影响这类引擎。
着力点:你的官网,以及和它放在一起比较的页面回答前会先搜索,但在我们的扫描中,它依赖百科、新闻和名录类网站的程度远高于品牌官网。
着力点:承载你的事实、且受信任的第三方页面根据模型已经学到的内容作答。它的变化取决于关于你的信息是否被广泛、一致地发布——这是见效最慢、但最持久的着力点。
着力点:同一套事实,广泛且一致地发布分类来自每一次扫描,而不是一份固定名单:引擎改变回答方式,它的分类也随之改变。
可见度分数只是工作的起点。下面这些分析告诉你下一步做什么,以及做了之后有没有效果。
我们把每个问题按买家所处阶段拆分。买家还不认识品牌时,品牌官网只占 AI 所读来源的 0.7%(越南 12 个品牌、3,011 条带引用的回答)。所以我们会指出是哪些第三方页面决定了第一个答案,并针对它们做计划。
我们抓取每个引擎引用的页面,分析其结构、时效、schema 和篇幅。你的内容要达到的是一条实测标准,而不是一份写作风格指南。
我们读取你的公开页面,并与 AI 的回答并排对照:AI 哪里与你矛盾、哪里一片空白、哪里漏掉了你已发布的内容。修正落在源头——你的官网——而不是进入我们的数据库。
你记录的每个行动都标注日期,并核验确已上线。在同一个冻结面板上,把它所针对问题的变化与你没有动过的问题对比;只有比对照组高出 10 个百分点以上的提升才算数。
回答由模型评分,而这个模型要在每种语言上与人工盲标结果对照检验。新的评分模型只有与人工标注一致,才会被采用。
如果引擎没有作答,或页面加载失败,这条回答会标记为失败——绝不计为你的品牌缺席——每份报告都会注明其覆盖率。
发现买家在问什么 → 测量 AI 怎么回答 → 用你自己的事实补上缺失的部分 → 记录已上线的内容 → 在同一面板上再测量。
只用你的公开页面与文档建立事实库;每个市场 110 条买家语言的问题,其中 20 条为重点;以这些事实为依据的标准答案。
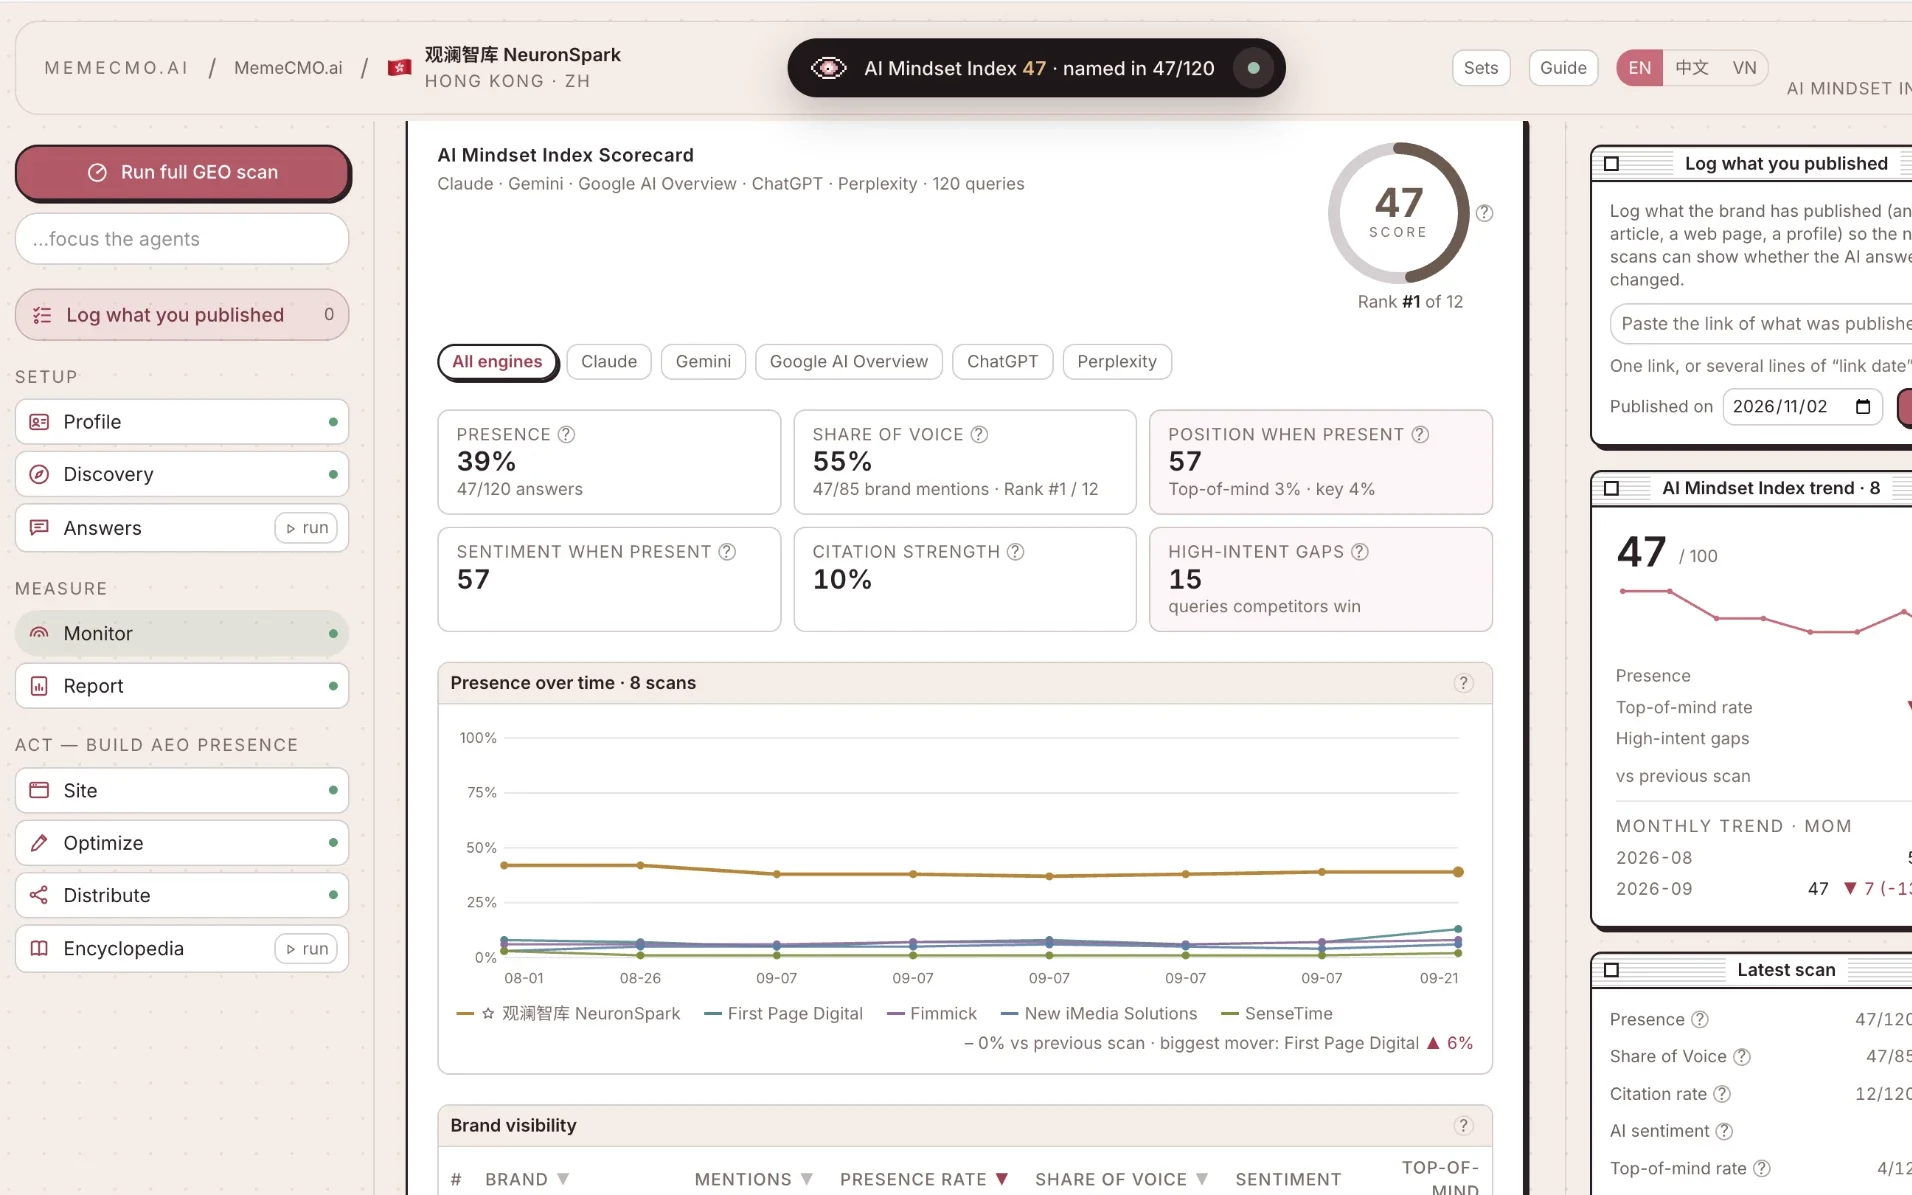
五个引擎、真实界面、一个冻结面板。出现率走势、声量份额,可按引擎、按问题查看——每个格子都能点开背后的回答。
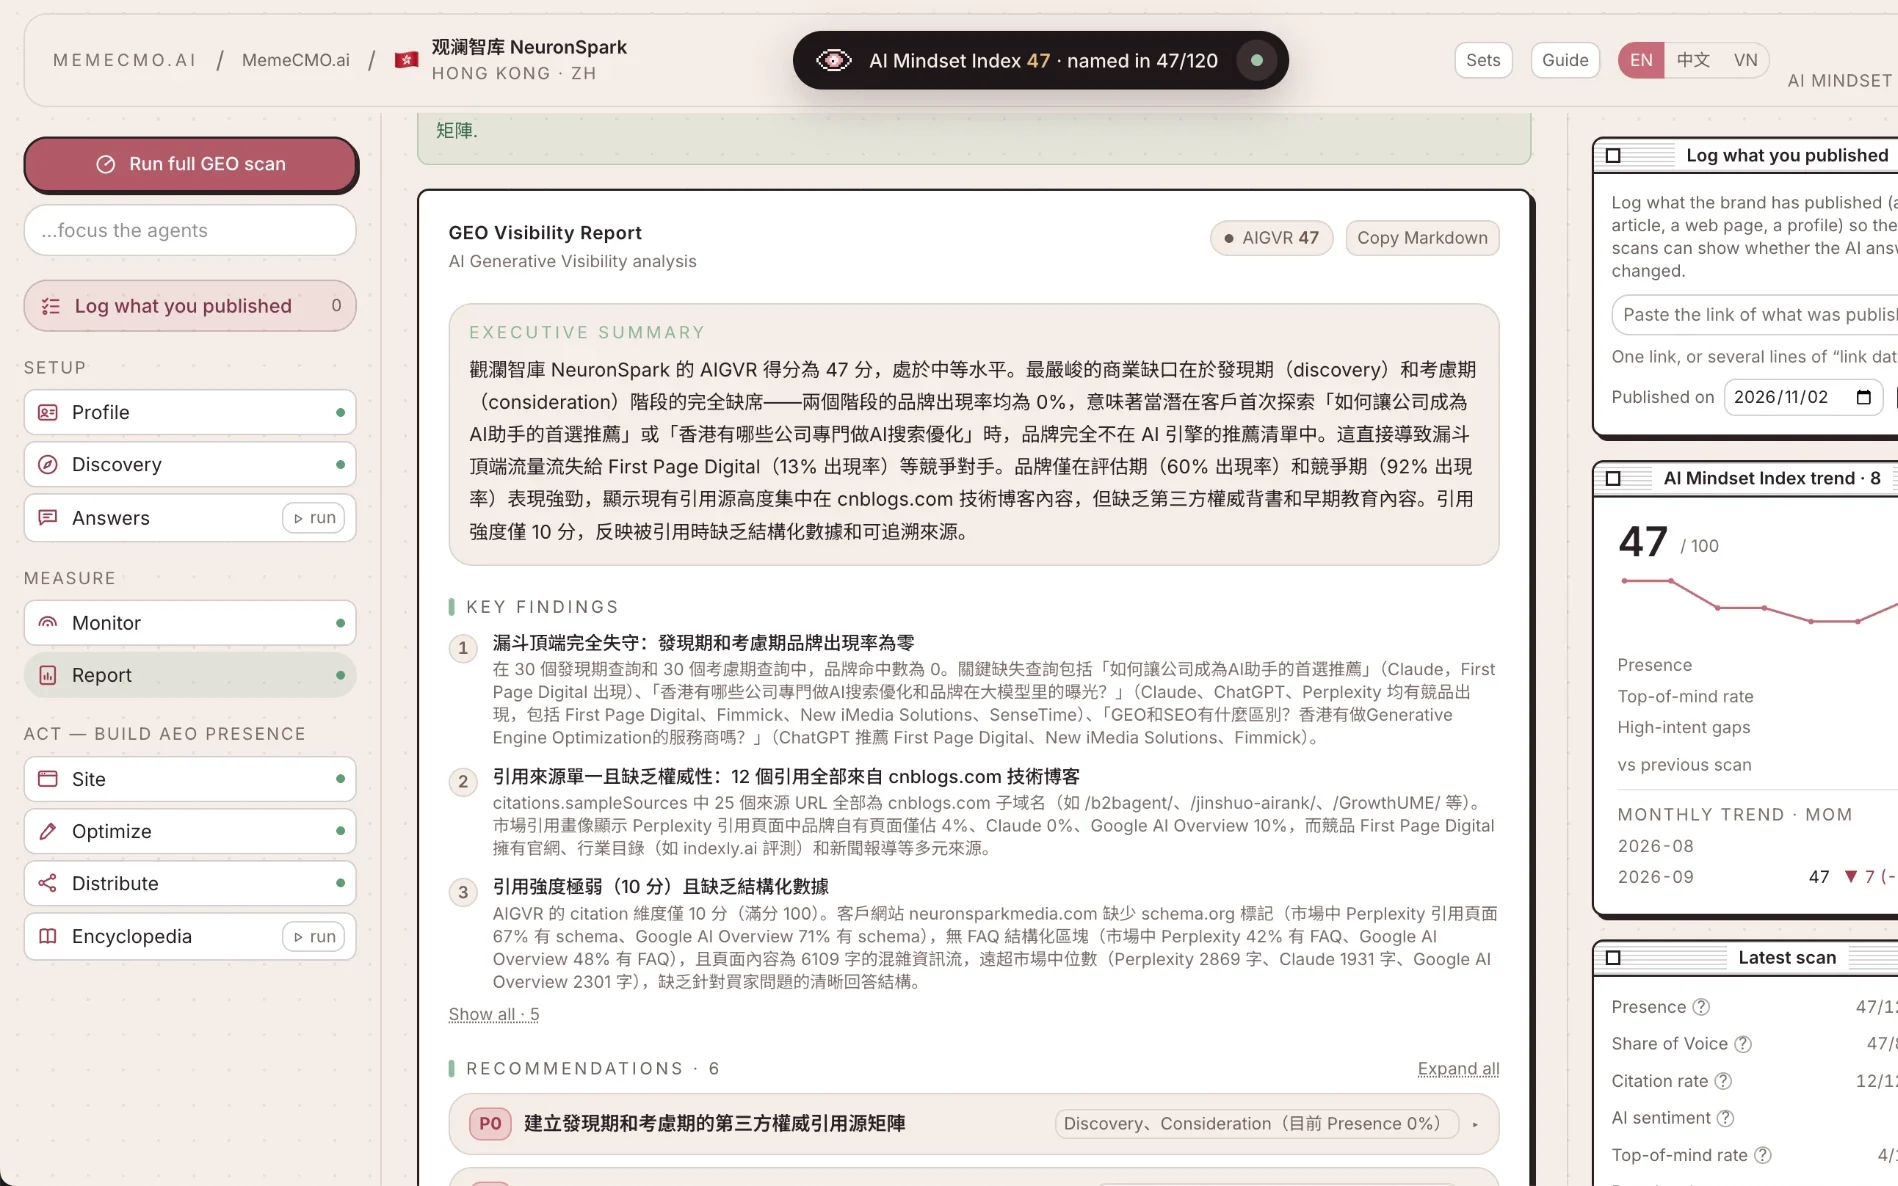
什么变了、为什么重要、下一步做什么——附上证据,另有按品牌所处阶段撰写的周报。完整扫描一次跑完「发现 → 监测 → 报告」。
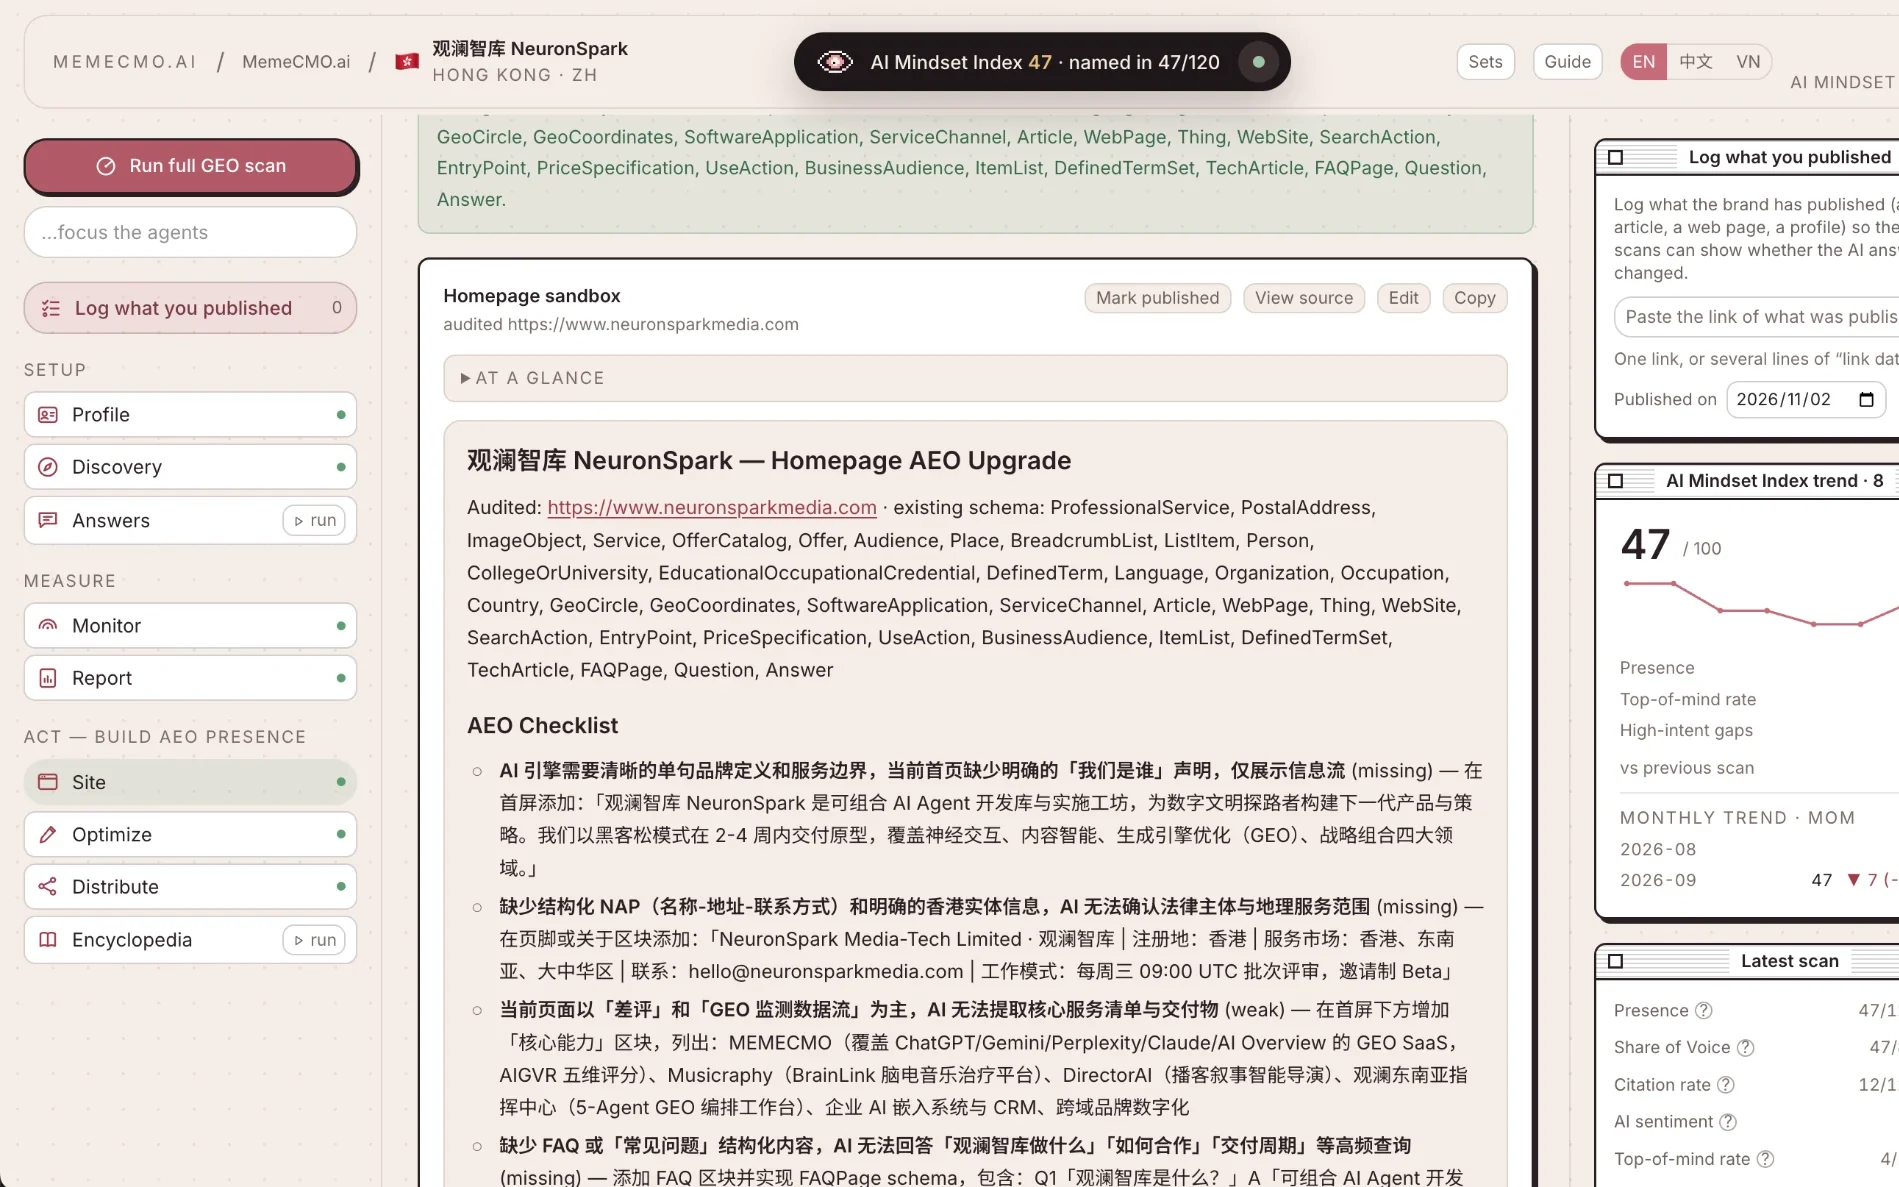
可直接粘贴的 JSON-LD,以及针对你自有页面的具体修改;针对目前由竞品胜出的问题,提供可直接发布的页面与 FAQ。
面向你所在市场中 AI 已在引用的信源的投放包(排除竞品),以及附合规路径的百科草稿。
你这边一位负责人,我们这边十个智能体:它们负责阅读、测量、建设和记录,你的团队负责审阅和决策。你无需招聘工程师。
这些是你可以要求我们兑现的承诺。每一条都能在工作区里看到,而不是幻灯片上的一句话。
每个智能体都交付可以发布的成果:一个页面、一段 schema、一份投放包、一篇百科草稿。由你审阅并发布;我们从不代你发布。
智能体只依据你官网上已公开的事实和你提供给我们的文档来写。没有出处的数字会留成空白,由你填写。
重新标注竞品、改写一个问题、修改一句话——都会连同理由记录下来,并在每次重跑时重新应用。团队的判断会持续积累,而不会流失。
每周一份通俗易懂的周报;最重要的那一项行动,会以卡片形式发到你的团队群聊:点一下确认,它就记入行动台账,接受测量。
每个比率都附分子和分母,定义写在公开的《测量标准》(v1.1)里。套餐之间只差范围,不差口径。
我们不出售 AI 回答中的位置,也不保证引擎会说什么。我们诚实测量,公开信源清单,并与 AI 已经在读的媒体合作。
一个项目 = 一个品牌 × 一个市场。在东南亚,本地语言的 AI 知识层近乎空白;在美国,州法改变正确答案——所以每个州都是独立市场。
全球品牌的英语 AI 认知已是红海。而在越南语、泰语、印尼语、马来语和菲律宾语里,AI 知识层仍大面积空白——先行者写下默认答案。在美国,买家问 AI 时自带州名("德州最好的人身伤害律师"),正确且合规的答案在州界两侧不同——一个全国分数会掩盖你真正输赢的地方。
定期扫描按套餐节奏运行;智能体在两次扫描之间建设;你记录的每个行动都在下一次扫描里被核验与归因。
品牌档案从你的官网建立事实库;发现智能体用买家的语言写出提示词面板;监测测量五个引擎;报告排出缺口优先级。约五分钟拿到 Day-0 基线,之后面板冻结。
标准答案、JSON-LD、缺口内容、投放、百科草稿——每一项都以你的事实为据,由你编辑,编辑在重跑后保留。内容上线后记一条行动:平台抓取并核验页面。
冻结面板上的定期扫描让分数可比。成效 = 目标题目的变化 − 对照题目的变化;只有超过 10 个百分点才算数。周报进邮箱、下跌告警、"现在就跑"用 Credit。
我们最常给出的回答——写成 AI 引擎也能干净引用的形式。 第 4 到 7 条按证据等级逐句标注:实测 = 有数据可复跑;设计 = 系统构造保证;厂商 = 平台一手文档;路线图 = 尚未上线,不作承诺。
申请平台开通或合作伙伴洽谈。告诉我们品牌与市场;我们跑出基线扫描,并带你解读结果。