Đưa thương hiệu của bạn trở thành câu trả lời của AI.

Xem ChatGPT, Gemini, Perplexity, Claude và Google AI Overview nói gì với khách hàng của bạn — và chúng đọc nguồn nào trước khi trả lời.

Quét xem trước miễn phí · câu trả lời thật từ ChatGPT & Google AI Overview · không cần thẻ
Đo trên năm công cụ AI
ChatGPT Gemini Perplexity Claude Google AI Overview
1.992câu trả lời AI có trích dẫn mà chúng tôi đã đọc tại Việt Nam trong tháng 9, trên 10 bảng thương hiệu thuộc 6 ngành.Tháng 9/2026 · 4 công cụ
0,7%nguồn AI đọc là website của chính thương hiệu, khi người mua chưa biết thương hiệu.12 thương hiệu · 3.011 câu trả lời có trích dẫn · tháng 6–10/2026
19,2%câu trả lời có trích dẫn nhắc tới vnexpress.net — nguồn AI dựa vào nhiều nhất tại Việt Nam.382/1.992 · tháng 9/2026
MemeCMO — Chúng tôi không đoán AI nói gì về bạn. Chúng tôi đo lường, khắc phục và chứng minh nó đã thay đổi.
Năm engine · mười agent · một tiêu chuẩn đo lường công khai
ĐO LƯỜNG · NĂM ENGINE · MỘT BỘ CÂU HỎI CỐ ĐỊNH

Hỏi AI điều người mua của bạn hỏi. Mỗi tuần, cùng những câu hỏi đó.

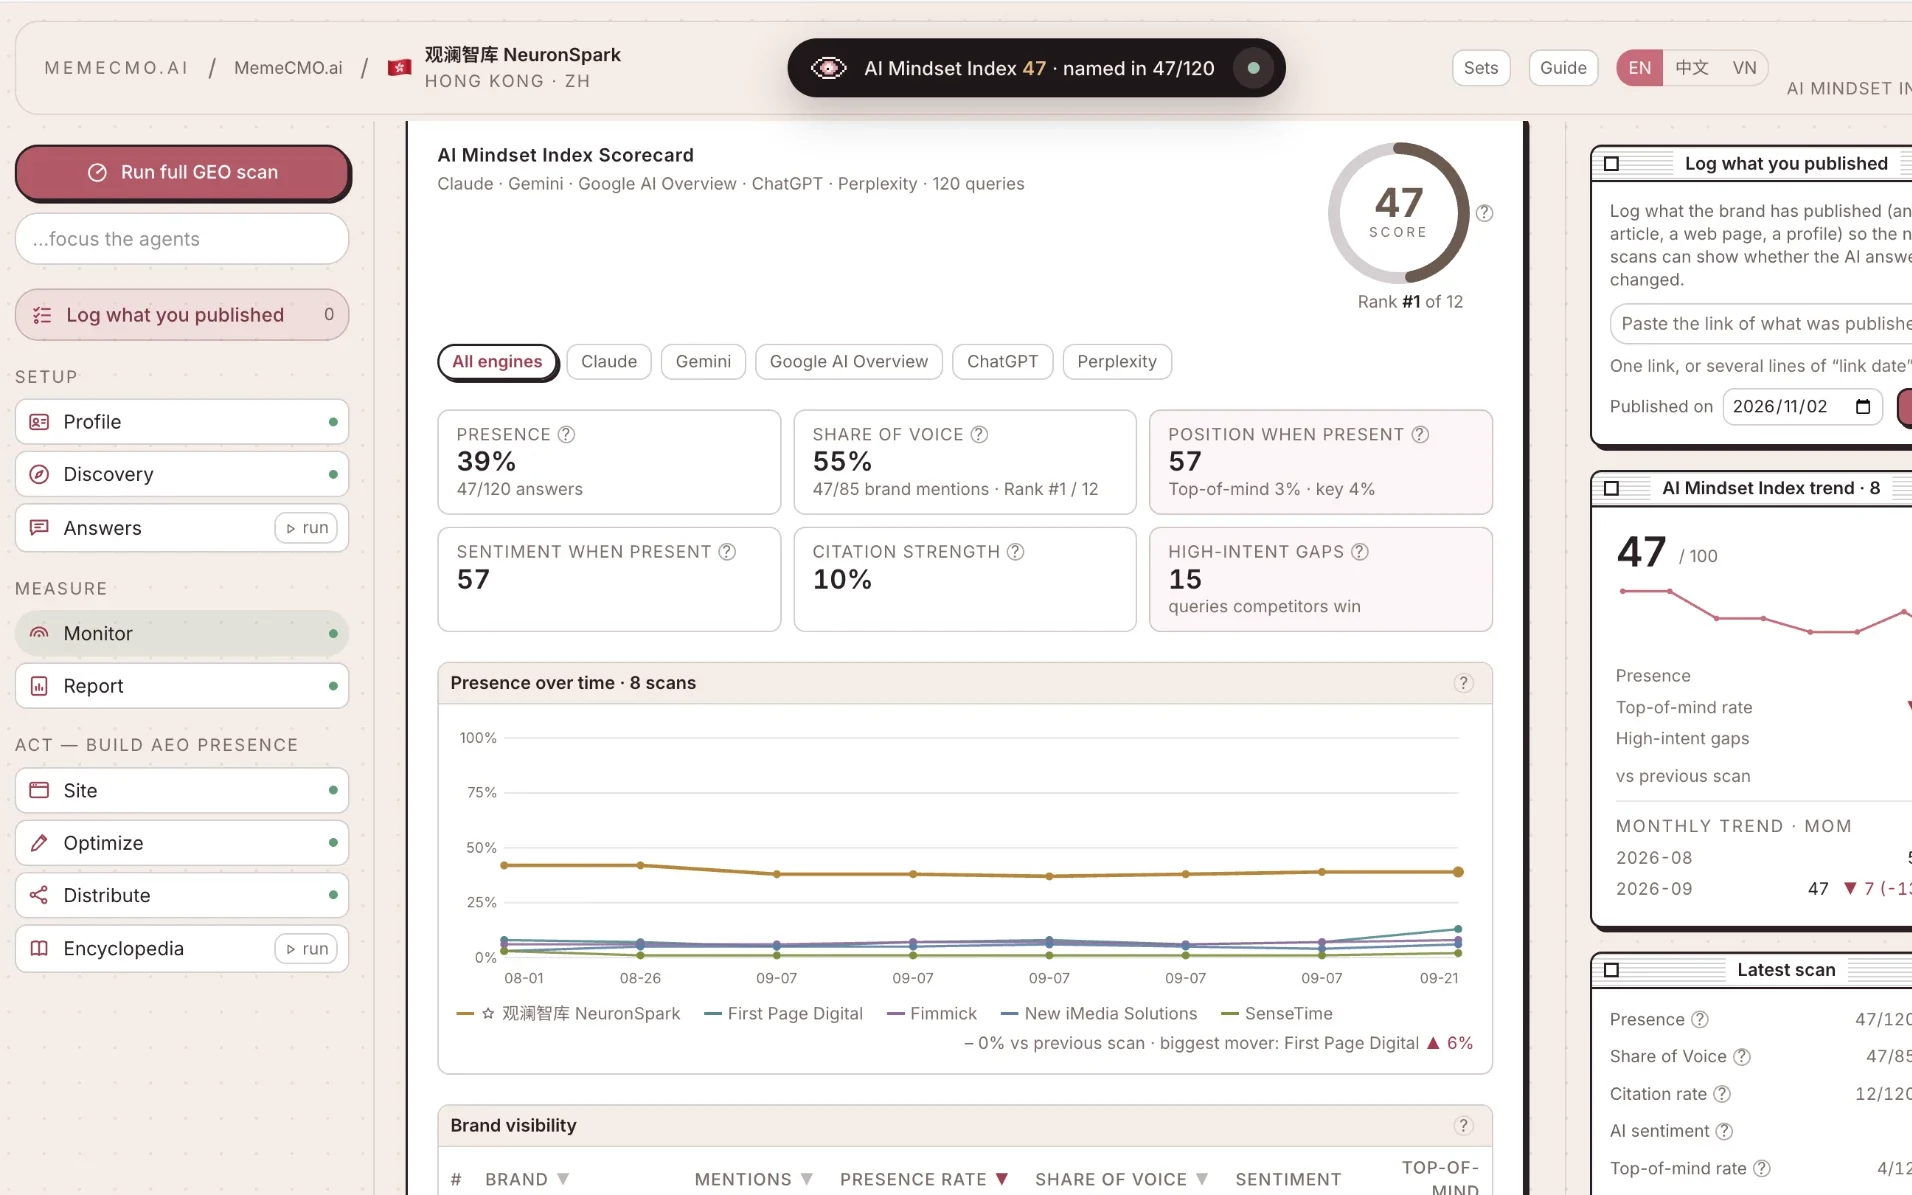
Mỗi lần quét đặt những câu hỏi người mua thật sự hỏi — bằng ngôn ngữ của họ, ở mọi giai đoạn mua hàng — cho ChatGPT, Gemini, Perplexity, Claude và trang Google AI Overview thật. Bộ câu hỏi được giữ cố định, nên khi điểm số thay đổi, đó là AI đã thay đổi, không phải bài kiểm tra.

  • Tỷ lệ xuất hiện, thị phần nhắc tên, độ nổi bật, cảm xúc và trích dẫn — mỗi tỷ lệ đều ghi kèm tử số và mẫu số
  • Từng engine riêng biệt: cùng một thương hiệu có thể dẫn đầu ở engine này và vắng mặt ở engine kế tiếp
  • Mỗi con số đều mở ra toàn bộ câu trả lời phía sau và các trang engine đã trích dẫn
app.memecmo.ai
Bảng giám sát MemeCMO: tỷ lệ xuất hiện theo thời gian, bảng hiện diện thương hiệu, theo engine
NGUỒN · AI TÌM Ở ĐÂU

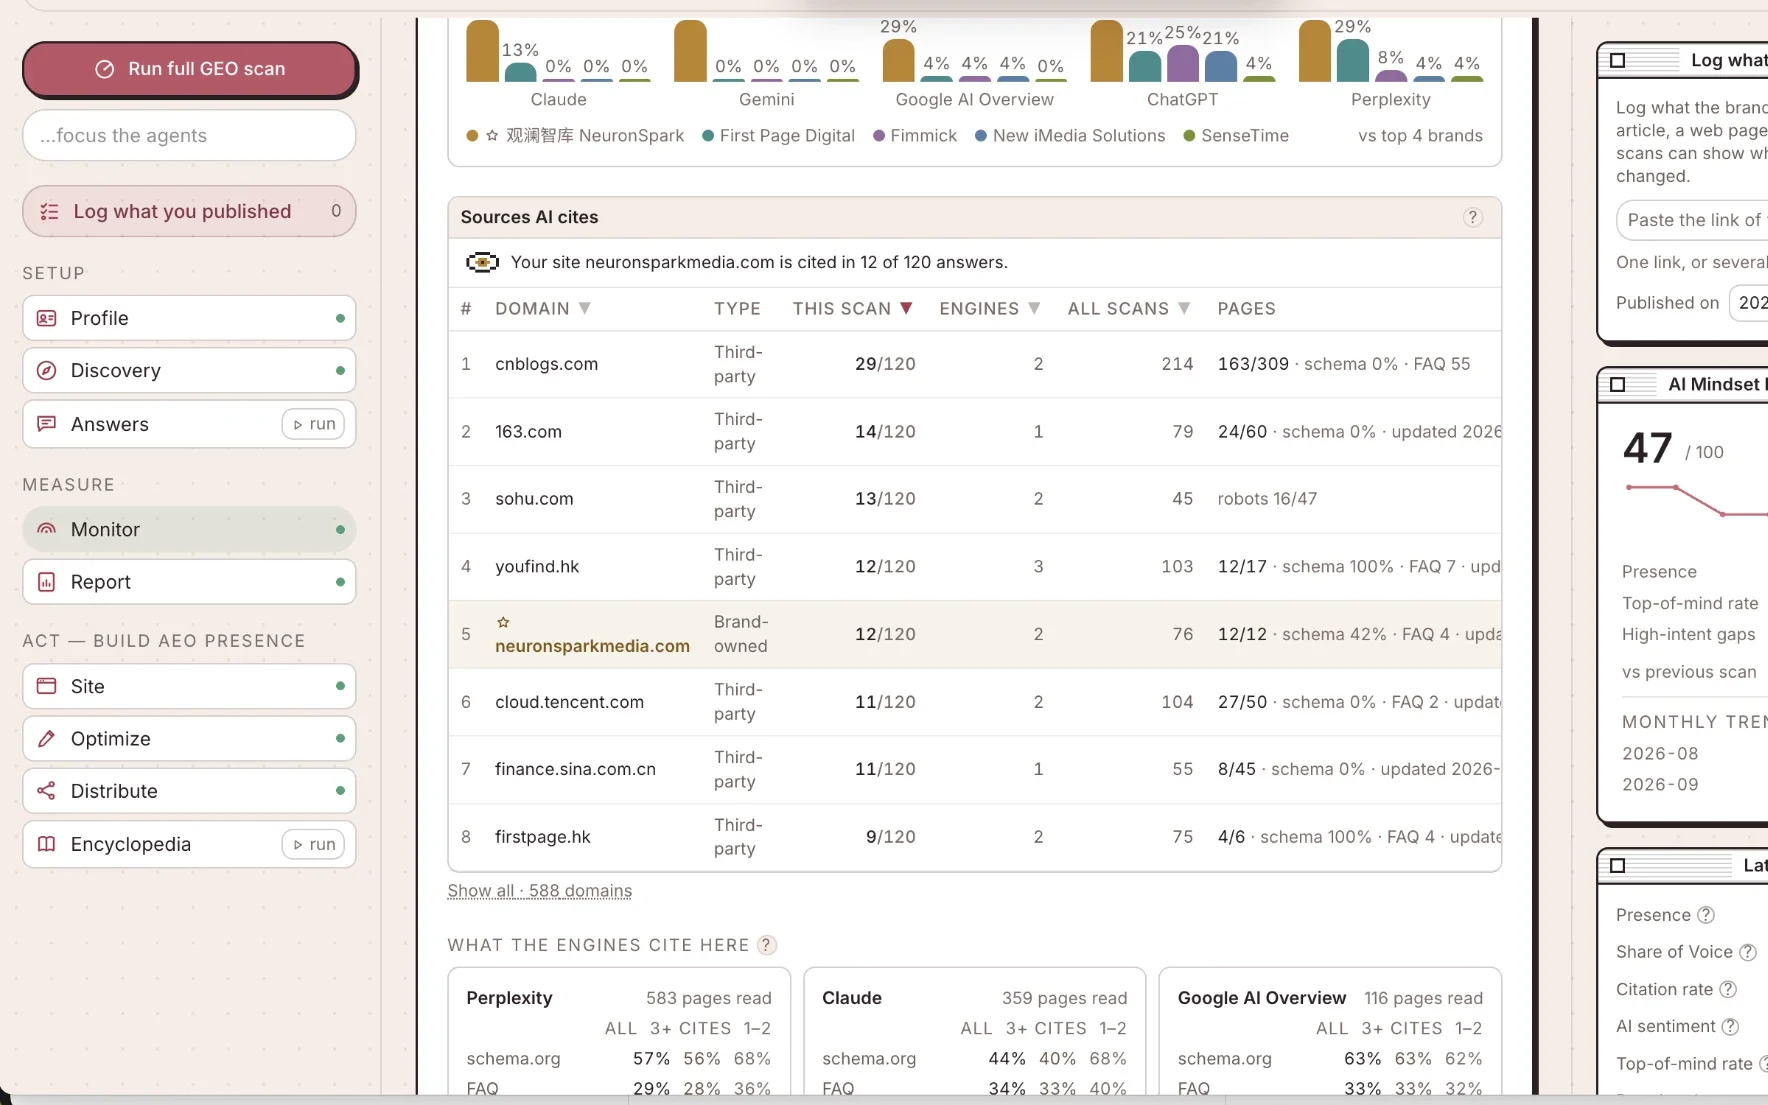
Chúng tôi đọc những trang AI đọc.

Ở mỗi thị trường, các engine dựa vào một danh sách ngắn các website. Chúng tôi xếp hạng chúng qua mọi lần quét, tải các trang được trích dẫn và lập hồ sơ — cấu trúc, độ mới, schema, độ dài — để “kiểu trang được trích dẫn” trở thành chuẩn mà nội dung của bạn được viết theo, thay vì phỏng đoán.

  • Các tên miền mỗi engine dựa vào tại thị trường của bạn, xếp hạng qua mọi lần quét
  • Điểm chung của các trang được trích dẫn, theo từng engine và theo tần suất được trích
  • Danh sách công khai hằng tháng các nguồn AI trích dẫn tại Việt Nam, được tự do tái sử dụng (CC BY 4.0)
Nguồn AI trích dẫn tại Việt Nam →
app.memecmo.ai
Các nguồn AI engine trích dẫn cùng đặc điểm trang theo tên miền
HÀNH ĐỘNG · MƯỜI AGENT · SẢN PHẨM BÀN GIAO

Mười agent bàn giao những câu trả lời còn thiếu.

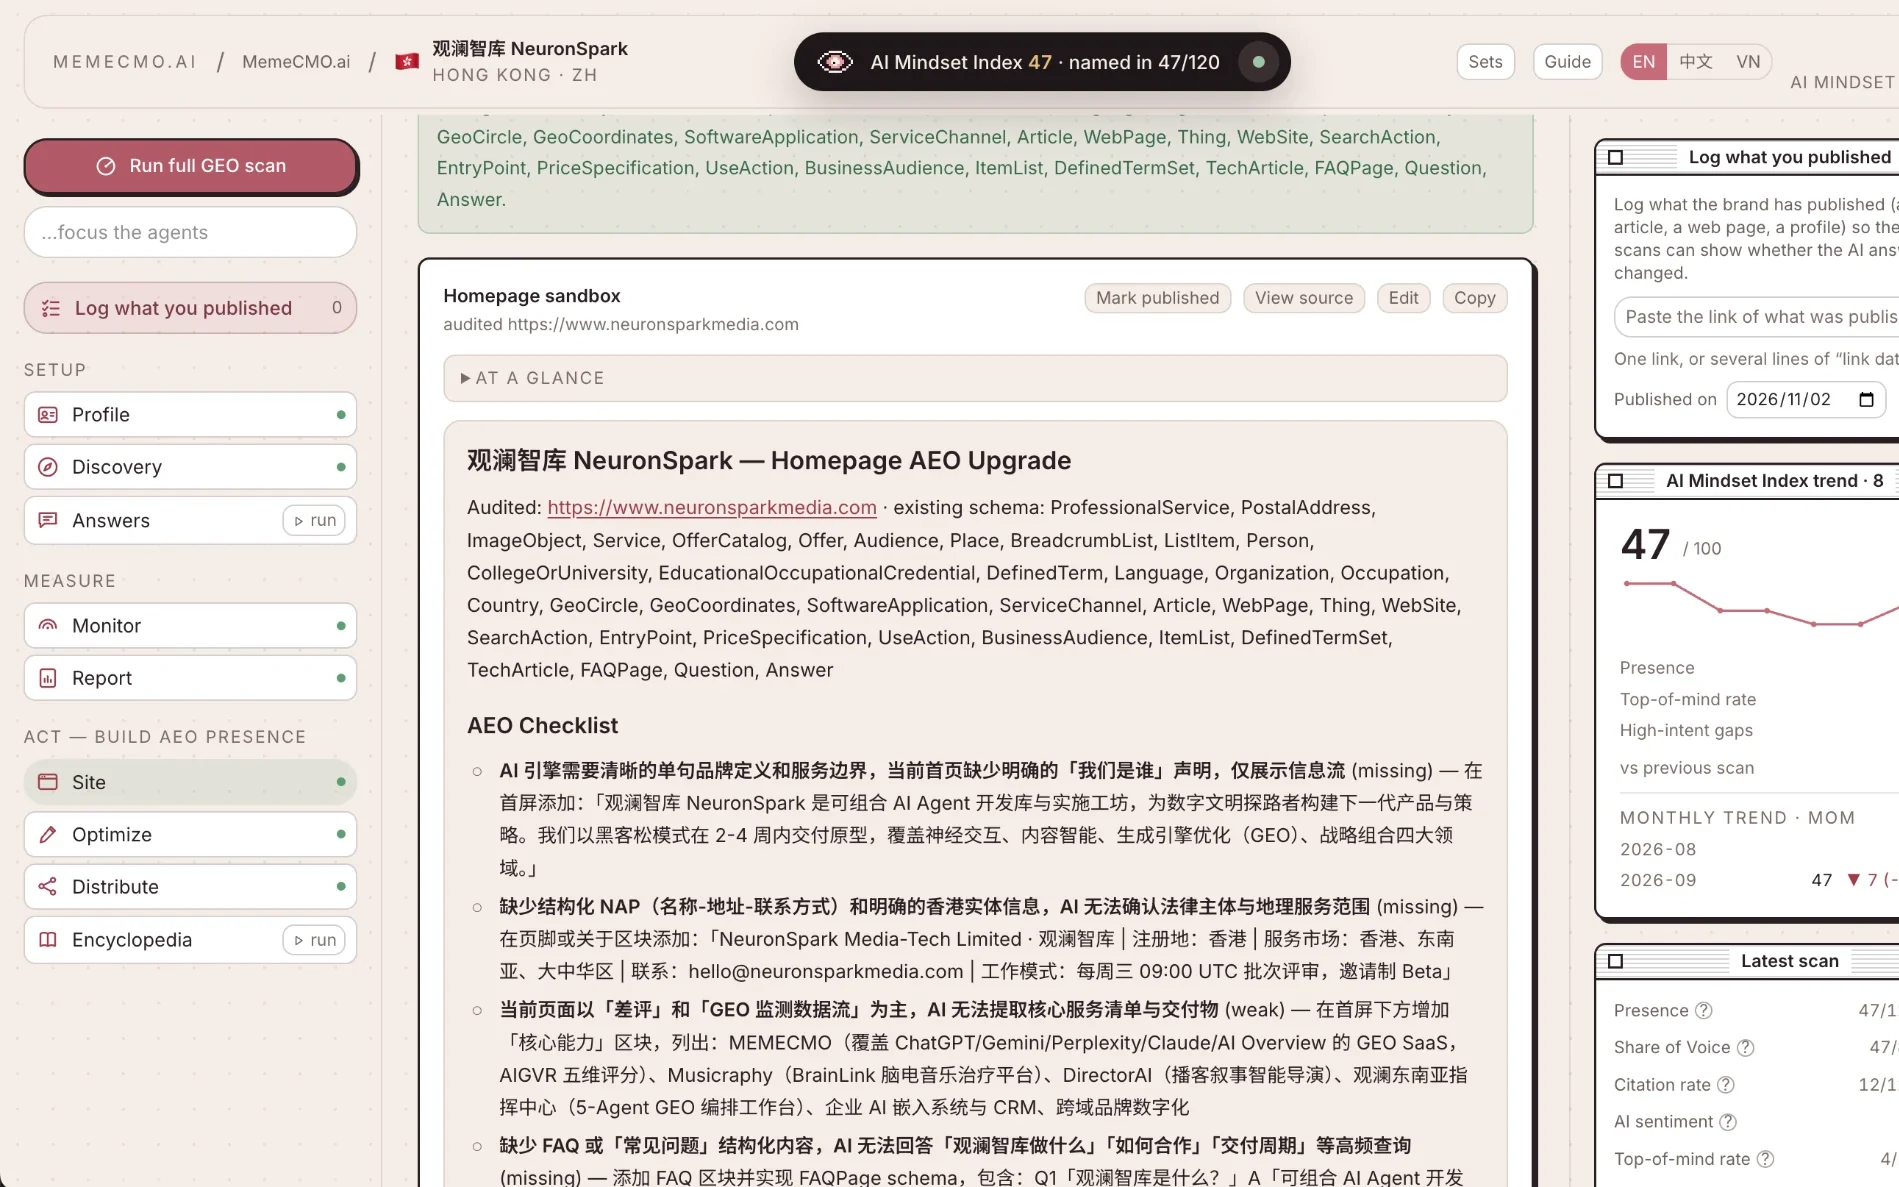
Câu trả lời chuẩn, chỉnh sửa trang, schema dán sẵn, nội dung lấp khoảng trống, bộ đăng tải và bản thảo bách khoa — bằng ngôn ngữ người mua, viết theo hồ sơ trích dẫn của thị trường bạn, từ những dữ kiện đã công khai trên website của bạn. Con số không có nguồn sẽ thành chỗ trống để bạn điền, không bao giờ bịa ra.

  • Giao việc cho agent ở bên trái, duyệt trên sân khấu ở giữa, theo dõi hoạt động trực tiếp ở bên phải
  • Mỗi bản thảo được định hướng theo những gì engine thật sự trích dẫn tại thị trường của bạn
  • Những gì đội của bạn đã sửa sẽ được giữ nguyên — mọi lần chạy lại đều tôn trọng điều đó
app.memecmo.ai
Không gian làm việc MemeCMO với các thẻ bàn giao và bảng hoạt động trực tiếp
CHỨNG MINH · TRƯỚC VÀ SAU

Bằng chứng, không phải cảm giác.

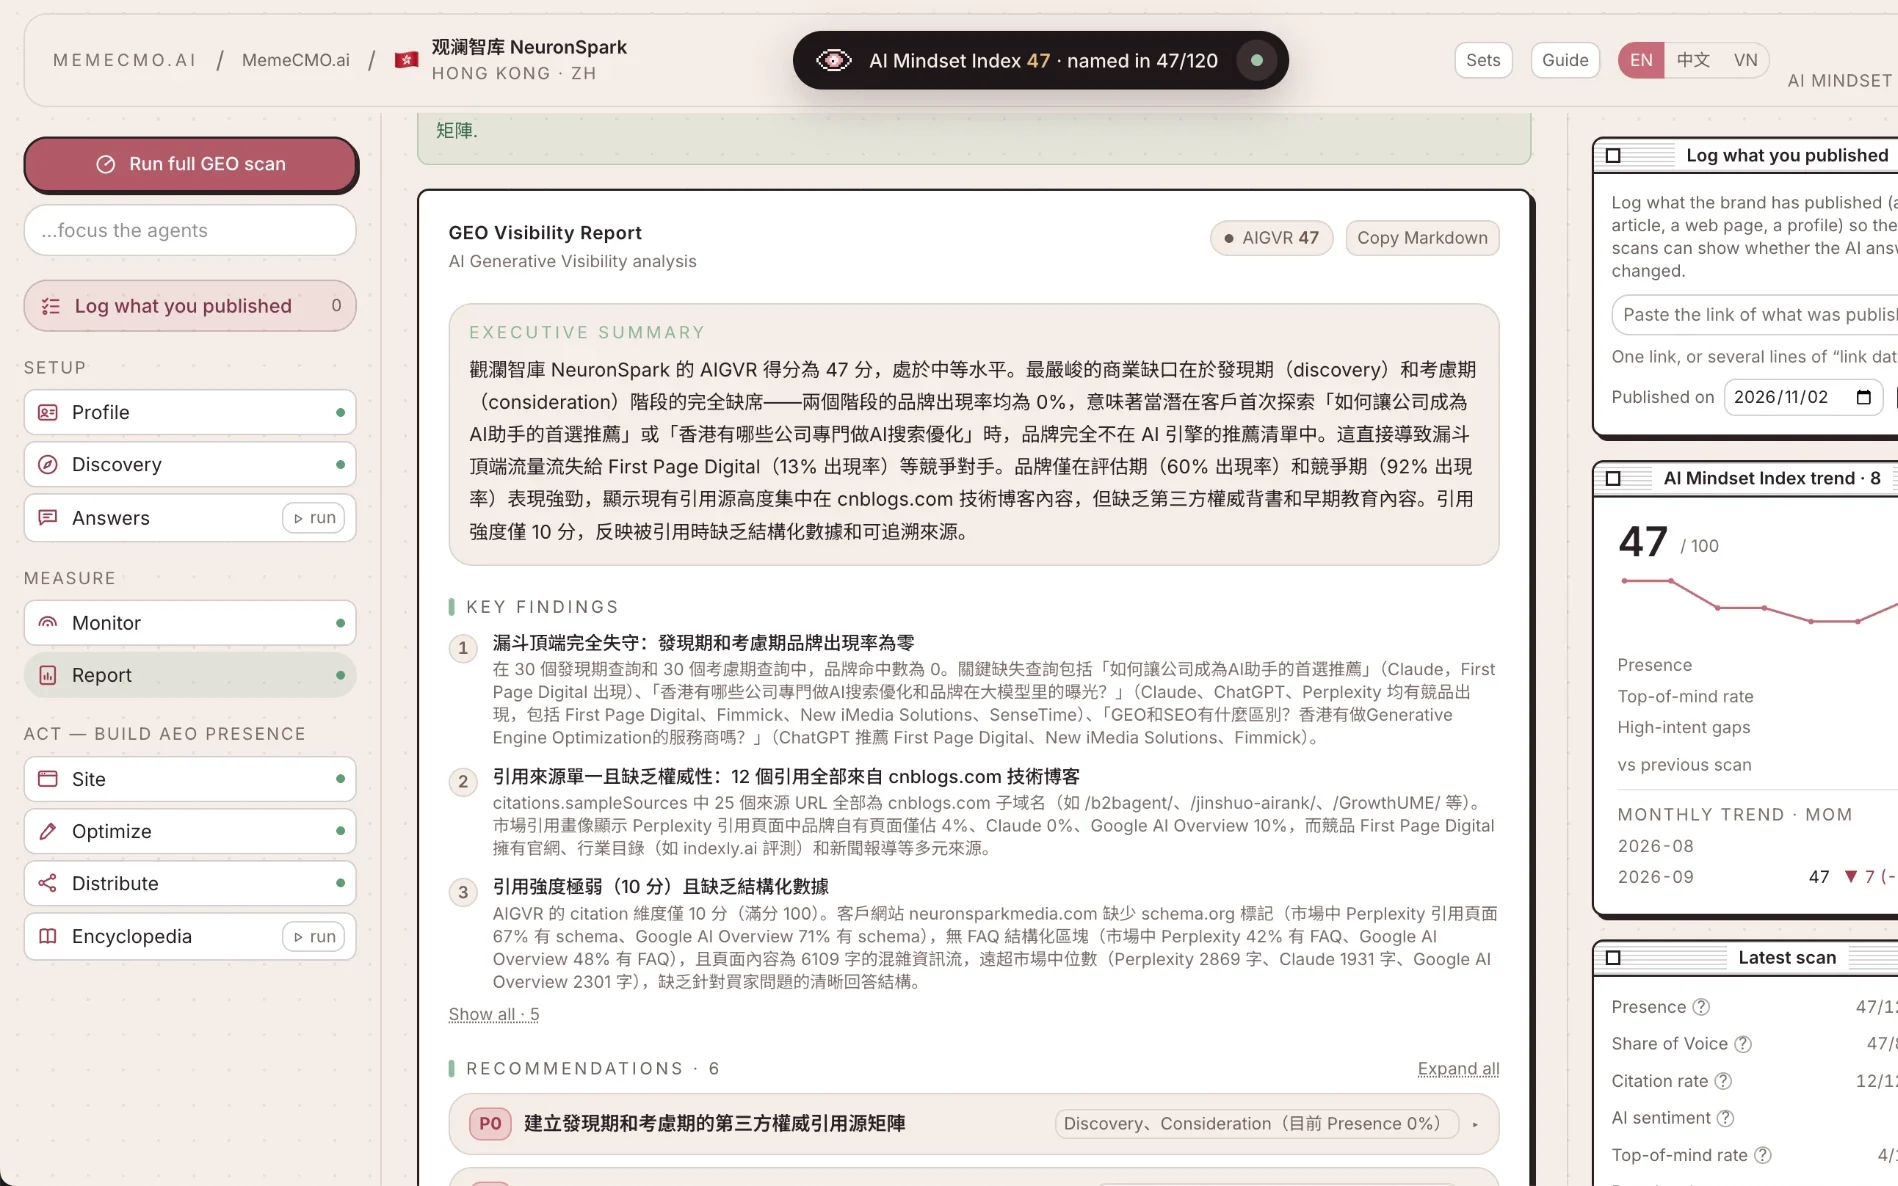
Ghi lại những gì đã lên sóng. Chúng tôi tải trang, tạo dấu nhận dạng nội dung và theo dõi xem engine có bắt đầu dùng trang đó không. Các lần quét tiếp theo cho thấy điều gì đã thay đổi — theo câu hỏi và theo engine — đặt cạnh những câu hỏi bạn không tác động.

  • Mỗi hành động đã ghi được xác minh là đã thật sự lên sóng, và các thay đổi của nó được theo dõi theo thời gian
  • Trước/sau theo từng câu hỏi và engine, cùng độ phủ website và các mâu thuẫn trong mỗi báo cáo
  • Một tiêu chuẩn đo lường công khai (v1.1) đằng sau mọi con số chúng tôi công bố
Đọc tiêu chuẩn đo lường →
app.memecmo.ai
Báo cáo MemeCMO với khuyến nghị thu gọn, độ phủ website và hành động đã xác minh
Mở bản demo trực tiếp →
Thương hiệu thật, đo lường thật — cập nhật hàng tuần, không cần đăng ký.
CÁC ENGINE

Ba kiểu câu trả lời AI.
Ba đòn bẩy khác nhau.

Không phải engine nào cũng đọc web. Chúng tôi phân loại từng engine theo chính những gì lần quét cho thấy — bao nhiêu câu trả lời của nó có kèm nguồn — vì thứ tác động đến mỗi loại là khác nhau.

01
PerplexityGoogle AI Overview

Đọc web, và cả website của bạn

Câu trả lời được ghép từ các trang tải về trực tiếp, kể cả trang của bạn. Trang của chính bạn, dữ liệu có cấu trúc và độ mới là những thứ tác động đến nhóm này trước tiên.

Đòn bẩy: website của bạn, và những trang được đem ra so sánh với nó
02
Claude

Đọc web, hiếm khi đọc website của bạn

Tìm kiếm trước khi trả lời, nhưng trong các lần quét của chúng tôi, nó dựa vào bách khoa, báo chí và trang danh bạ nhiều hơn hẳn so với website thương hiệu.

Đòn bẩy: các trang bên thứ ba đáng tin cậy có mang dữ kiện của bạn
03
ChatGPTGemini

Trả lời từ dữ liệu huấn luyện

Trả lời từ những gì mô hình đã học. Nó thay đổi theo những gì được công bố rộng rãi và nhất quán về bạn — đòn bẩy chậm nhất, nhưng bền lâu nhất.

Đòn bẩy: cùng một bộ dữ kiện, công bố rộng rãi và nhất quán

Phân loại đến từ mỗi lần quét, không phải từ một danh sách cố định: khi một engine thay đổi cách trả lời, nhóm của nó cũng thay đổi theo.

PHÂN TÍCH

Sáu phân tích đằng sau mỗi báo cáo.

Điểm hiển thị chỉ là nơi công việc bắt đầu. Đây là những phân tích cho bạn biết nên làm gì tiếp theo — và việc đó có hiệu quả hay không.

01

AI đọc gì, theo từng giai đoạn

Chúng tôi chia mọi câu hỏi theo giai đoạn của người mua. Khi người mua chưa biết thương hiệu, website của chính thương hiệu chỉ chiếm 0,7% nguồn AI đọc (12 thương hiệu, 3.011 câu trả lời có trích dẫn tại Việt Nam). Vì vậy chúng tôi chỉ ra những trang bên thứ ba nào quyết định câu trả lời đầu tiên — và lên kế hoạch cho chúng.

02

Trang được trích dẫn, mở ra và đo lường

Chúng tôi tải các trang mà mỗi engine trích dẫn và lập hồ sơ cấu trúc, độ mới, schema và độ dài. Nội dung của bạn có một chuẩn đã đo để đạt tới, thay vì một bộ hướng dẫn văn phong.

03

Website của bạn, đặt cạnh điều AI nói

Chúng tôi đọc các trang công khai của bạn và đặt chúng cạnh các câu trả lời: chỗ AI mâu thuẫn với bạn, chỗ AI không nói gì, chỗ AI bỏ sót điều bạn đã công bố. Việc sửa diễn ra tại nguồn — website của bạn — chứ không nằm trong cơ sở dữ liệu của chúng tôi.

04

Trước và sau, so với nhóm đối chứng

Mỗi hành động bạn ghi đều có ngày và được kiểm tra xem đã thật sự lên sóng. Biến động ở các câu hỏi mà hành động nhắm tới được so với các câu hỏi bạn không tác động, trên cùng bộ câu hỏi cố định; chỉ mức tăng cao hơn đối chứng trên 10 điểm mới được tính.

05

Mô hình chấm điểm được đối chiếu với nhãn của con người

Câu trả lời được một mô hình chấm điểm, và mô hình đó được đối chiếu với nhãn do con người chấm mù ở từng ngôn ngữ. Một mô hình chấm điểm mới chỉ được áp dụng khi nó khớp với các nhãn đó.

06

Câu trả lời lỗi không bao giờ bị tính là “không được nhắc đến”

Nếu một engine không trả lời hoặc một trang không tải được, câu trả lời được đánh dấu là lỗi — không bao giờ bị tính là thương hiệu của bạn vắng mặt — và mọi báo cáo đều nêu rõ độ phủ của nó.

MƯỜI AGENT

Mười agent.
Mỗi agent để lại một sản phẩm bàn giao.

Khám phá người mua hỏi gì → đo AI trả lời gì → xây phần còn thiếu từ dữ kiện của chính bạn → ghi lại những gì đã lên sóng → đo lại trên cùng bộ câu hỏi.

01

Hồ sơ · Khám phá · Câu trả lời chuẩn

Kho dữ kiện chỉ xây từ các trang và tài liệu công khai của bạn; 110 câu hỏi người mua mỗi thị trường bằng ngôn ngữ của họ, trong đó 20 câu trọng điểm; câu trả lời chuẩn dựa trên chính các dữ kiện đó.

02

Giám sát

Năm engine, giao diện thật, một bộ câu hỏi cố định. Tỷ lệ xuất hiện theo thời gian, thị phần nhắc tên, theo engine và theo câu hỏi — mỗi ô đều mở ra câu trả lời phía sau.

03

Báo cáo · Quét đầy đủ

Điều gì đã thay đổi, vì sao quan trọng, nên làm gì tiếp — kèm bằng chứng, cùng bản tin hằng tuần viết cho giai đoạn thương hiệu bạn đang ở. Quét đầy đủ chạy Khám phá → Giám sát → Báo cáo trong một lượt.

04

Website · Tối ưu

JSON-LD dán sẵn và các chỉnh sửa cụ thể cho trang của chính bạn; trang và FAQ sẵn đăng cho những câu hỏi mà đối thủ đang thắng hiện nay.

05

Phân phối · Bách khoa

Bộ đăng tải cho các nguồn AI đã trích dẫn tại thị trường của bạn, loại trừ đối thủ, và bản thảo bách khoa kèm lộ trình hợp quy.

memecmo.ai

Không phải dashboard —
là đội agent biết bàn giao.

Một người phụ trách ở phía bạn, mười agent ở phía chúng tôi: agent đọc, đo, xây dựng và ghi lại; đội của bạn duyệt và quyết định. Bạn không cần tuyển kỹ sư.

LÀM VIỆC CÙNG CHÚNG TÔI

Sáu cam kết, gắn liền với dịch vụ.

Những điều bạn có thể yêu cầu chúng tôi giữ đúng cam kết. Mỗi điều đều thấy được trong workspace, không phải một dòng trên slide.

01

Sản phẩm bàn giao, không phải lời khuyên

Mỗi agent bàn giao thứ bạn có thể xuất bản: một trang, một khối schema, một bộ đăng tải, một bản thảo bách khoa. Bạn duyệt và đăng; chúng tôi không bao giờ đăng thay bạn.

02

Dữ kiện chỉ lấy từ website của bạn

Agent chỉ viết từ những dữ kiện đã công khai trên website của bạn và tài liệu bạn giao cho chúng tôi. Con số không có nguồn sẽ thành chỗ trống để bạn điền.

03

Chỉnh sửa của bạn được giữ vĩnh viễn

Gắn lại nhãn đối thủ, viết lại một câu hỏi, sửa một câu văn — mỗi thay đổi được lưu kèm lý do và áp lại ở mọi lần chạy lại. Phán đoán của đội bạn được tích lũy thay vì mất đi.

04

Mỗi tuần một bản tin, một thẻ hành động

Bản tin hằng tuần bằng ngôn ngữ dễ hiểu, và hành động quan trọng nhất được gửi thành một thẻ trong nhóm chat của đội bạn: chạm để xác nhận là hành động đó được đưa vào sổ theo dõi để đo lường.

05

Một tiêu chuẩn bạn kiểm tra được

Mỗi tỷ lệ đều kèm tử số và mẫu số, được định nghĩa trong Tiêu chuẩn đo lường công khai (v1.1). Các gói khác nhau về phạm vi, không bao giờ khác về phương pháp.

06

Không bán thứ hạng, không hứa hẹn về AI

Chúng tôi không bán vị trí trong câu trả lời của AI, cũng không đảm bảo một engine sẽ nói gì. Chúng tôi đo lường trung thực, công bố danh sách nguồn và hợp tác với những kênh truyền thông mà AI vốn đã đọc.

THỊ TRƯỜNG

Đông Nam Á, sáu thị trường.
Hoa Kỳ, theo từng bang.

Một dự án là một thương hiệu × một thị trường. Ở Đông Nam Á, tầng tri thức AI bằng ngôn ngữ địa phương gần như trống; ở Hoa Kỳ, luật bang thay đổi câu trả lời đúng — nên mỗi bang là một thị trường riêng.

🇻🇳
Việt Nam
Tiếng Việt
ChatGPT 8 triệu+ MAU. Cạnh tranh GEO gần bằng không. Thị trường chủ lực của chúng tôi.
🇹🇭
Thái Lan
ภาษาไทย
Hệ sinh thái AI tiếng Thái mới hình thành — cửa sổ thương hiệu rộng mở.
🇮🇩
Indonesia
Bahasa Indonesia
270 triệu dân, thị trường lớn nhất khu vực — mức tiếp nhận AI dẫn đầu Đông Nam Á.
🇲🇾
Malaysia
Bahasa Melayu
Giao lộ Malay / Anh / Hoa — GEO cần phối hợp ba ngôn ngữ.
🇺🇸
Hoa Kỳ
Theo bang · us.memecmo.ai
50 bang, hạng nhất CA · TX · FL · NY. Các ngành được quản lý nơi luật bang thay đổi câu trả lời: pháp lý, bảo hiểm, y tế, dịch vụ gia đình, năng lượng mặt trời.

Vì sao là những thị trường này?

Nhận thức AI bằng tiếng Anh cho thương hiệu toàn cầu đã là đại dương đỏ. Trong tiếng Việt, Thái, Indonesia, Malay và Filipino, tầng tri thức AI vẫn phần lớn bỏ trống — người đi trước viết nên câu trả lời mặc định. Và tại Hoa Kỳ, người mua hỏi AI kèm tên bang ("luật sư thương tật tốt nhất ở Texas"), câu trả lời đúng và hợp quy khác nhau ở mỗi ranh giới bang — một điểm số toàn quốc che giấu nơi bạn thực sự thắng hay thua.

CÁCH VẬN HÀNH

Cơ sở. Xây dựng. Chứng minh — trên cùng bộ câu hỏi.

Quét định kỳ chạy theo nhịp gói của bạn; các agent xây dựng giữa các lần quét; mỗi hành động bạn ghi được xác minh và quy kết ở lần quét sau.

NGÀY 0 · CƠ SỞ

Hồ sơ, bộ câu hỏi, lần quét đầu

Hồ sơ xây kho dữ kiện từ website của bạn; Khám phá viết bộ câu hỏi bằng ngôn ngữ người mua; Giám sát đo năm engine; Báo cáo xếp ưu tiên khoảng trống. Đường cơ sở Ngày 0 trong khoảng năm phút, trên bộ câu hỏi sau đó được cố định.

TUẦN 1–4 · XÂY DỰNG

Bàn giao tài sản, ghi hành động

Câu trả lời chuẩn, JSON-LD, nội dung lấp khoảng trống, đăng tải, bản thảo bách khoa — mỗi thứ dựa trên dữ kiện của bạn, do bạn chỉnh, chỉnh sửa được giữ khi chạy lại. Khi có gì lên sóng, ghi lại: nền tảng tải và xác minh trang.

MỖI KỲ · CHỨNG MINH

Đo lại, quy kết, điều chỉnh

Quét định kỳ trên bộ câu hỏi cố định giữ điểm số so sánh được. Hiệu quả = thay đổi ở câu hỏi bạn nhắm tới trừ thay đổi ở câu đối chứng; chỉ tính thay đổi trên 10 điểm. Bản tin vào hộp thư, cảnh báo sụt giảm, credit cho “chạy ngay”.

CÂU HỎI THƯỜNG GẶP

Câu hỏi, đã có câu trả lời.

Những câu trả lời chúng tôi đưa ra thường xuyên nhất — viết để các AI engine cũng có thể trích dẫn gọn gàng. Mục 4–7 gắn nhãn từng câu: đo được = có dữ liệu chạy lại được; theo thiết kế = do cấu trúc hệ thống bảo đảm; tài liệu nhà cung cấp = trang của chính nền tảng; lộ trình = chưa có, không phải cam kết.

GEO (Tối ưu hóa Công cụ Sinh tạo) là gì?
GEO là thực hành tối ưu hóa cách thương hiệu được thể hiện bên trong các AI engine sinh tạo như ChatGPT, Gemini, Perplexity, Claude và Google AI Overview. SEO nhắm vào danh sách liên kết xếp hạng; GEO nhắm vào chính câu trả lời — thương hiệu có được nhắc đến không, nổi bật ra sao, chính xác đến đâu và engine trích dẫn nguồn nào.
GEO khác SEO thế nào?
SEO tối ưu thứ hạng trong danh sách liên kết xanh; GEO tối ưu sự có mặt, độ chính xác và độ nổi bật bên trong câu trả lời được sinh ra. Đòn bẩy khác nhau: dữ liệu có cấu trúc, trích dẫn bên thứ ba uy tín, câu trả lời chuẩn cho câu hỏi người mua, nội dung viết để được trích dẫn — không phải backlink và mật độ từ khóa.
MemeCMO đo gì, và đo thế nào?
Năm chỉ số chuẩn theo từng engine, mỗi chỉ số kèm tử số và mẫu số: tỷ lệ xuất hiện (câu trả lời nhắc bạn ÷ tổng câu trả lời), thị phần nhắc tên (lượt nhắc bạn ÷ tổng lượt nhắc mọi thương hiệu theo dõi, tổng 100%), độ nổi bật, cảm xúc khi xuất hiện, và trích dẫn (câu trả lời trích tên miền của bạn). Thêm tỷ lệ đề xuất đầu tiên và danh sách khoảng trống ý định cao. Tất cả đo trên bộ câu hỏi cố định của mỗi thị trường, định nghĩa trong Tiêu chuẩn đo lường khả năng hiển thị AI v1.1 công khai.
Mỗi tài khoản AI có bộ nhớ và cá nhân hóa khác nhau, vì sao dữ liệu scan đáng tin?
Một câu: scan hỏi trong phiên sạch, không có bộ nhớ của tài khoản nào, nên số đo là mức sàn không bao giờ nói quá. Scan không dùng tài khoản của bất kỳ ai. Mỗi câu hỏi được gửi tới engine qua giao diện lập trình trong một phiên sạch: không lịch sử hội thoại, không bộ nhớ, không cá nhân hóa, temperature bằng 0, câu chữ khóa từng từ; mỗi lần scan hỏi 24 câu trên 5 engine theo nhịp cố định, toàn bộ câu trả lời và nguồn trích dẫn được lưu lại (theo thiết kế). Một số đo đại diện cho tình huống một người dùng chưa có lịch sử hỏi câu đó lần đầu bằng ngôn ngữ bản địa, tức là đường cơ sở mà mọi câu trả lời cá nhân hóa đều mọc ra từ đó (theo thiết kế). Scan lặp trong cùng ngày: engine trả lời từ bộ nhớ huấn luyện (ChatGPT, Gemini) lật 0–1 trên 24 câu, engine đọc web (Claude, Perplexity, Google AI Overview) lật 0–4 trên 24, tổng điểm chênh 1–5 điểm trong ngày, phần chênh nằm ở các engine tìm kiếm (đo được, 11 lần lặp trên hai panel, 7–11/2026). Chúng tôi cũng đưa cùng 20 câu lên ChatGPT web không đăng nhập để đối chiếu: 10 câu có tên thương hiệu đạt 10/10 ở cả hai phía; 10 câu không có tên, bản web có tìm kiếm nêu tên thương hiệu 5 lần so với 1 lần ở số đo qua giao diện lập trình, và không bao giờ ngược lại. Số đo phiên sạch là mức sàn, không bao giờ nói quá (đo được, 02-11-2026). Chúng tôi cũng chạy 20 câu đó trên bốn tài khoản đã đăng nhập, bật bộ nhớ, của chính nhà sáng lập: 10 câu có tên thương hiệu đều 10/10; ở 10 câu không có tên, Gemini, Claude và Perplexity mỗi bên nêu thương hiệu 4 lần, cùng bậc với 1–4 lần của giao diện lập trình, và chỉ có 1 câu giao diện lập trình nêu mà cả ba tài khoản đó không nêu; ChatGPT đăng nhập đạt 10/10 vì bộ nhớ tài khoản mang thương hiệu đã hỏi trước đó vào mọi câu trả lời sau; cùng tài khoản đó tắt bộ nhớ chạy lại thì câu không tên giảm còn 3/10, trở về mức của giao diện lập trình (đo được, 02-11-2026). Chỉ scan theo lịch mới vào chuỗi xu hướng, scan thủ công chỉ để kiểm tra điểm; việc engine đổi model hay lấy dữ liệu thất bại đều được ghi theo từng câu và đánh dấu trong báo cáo (theo thiết kế).
Điểm AIGVR hay tỷ lệ xuất hiện bao nhiêu thì được xem là tốt?
Một câu: không có điểm đạt; ba thước đo, và được nêu tên ở câu ngành hàng mới là thực lực. Không có điểm đạt chung cho mọi ngành; báo cáo đưa ba thước đo cạnh nhau (theo thiết kế). Một, so với đường cơ sở Day-0 của chính bạn: mục tiêu hợp đồng được viết dưới dạng mức cải thiện so với lần đo đầu. Hai, so với các đối thủ được đo trong cùng lần scan: thị phần tiếng nói lấy mọi thương hiệu được nêu tên làm mẫu số và cộng đúng 100%, nên AI đang gợi ý ai là thấy ngay. Ba, tách câu hỏi có tên thương hiệu khỏi câu hỏi chỉ nói về ngành hàng: trên mọi panel chúng tôi đã đo, tỷ lệ xuất hiện khi người dùng gõ tên bạn gần như luôn sát 100% và chứng minh rất ít; chiến trường thật là bạn có được nêu tên khi người dùng chỉ hỏi về ngành hàng hay không, tỷ lệ này thường chỉ một đến hai phần mười và đó chính là dư địa tăng trưởng (đo được). Benchmark ngành chỉ được công bố khi có từ 5 khách hàng trở lên trong cùng ngành, nên hiện tại benchmark chính là đối thủ của bạn trên thị trường (theo thiết kế). Mọi tỷ lệ đều kèm tử số và mẫu số (theo thiết kế).
Nếu chỉ số tăng, làm sao biết đó là nhờ GEO chứ không phải PR, quảng cáo hay dao động tự nhiên của AI?
Một câu: ghi nhận, xác minh, câu đối chứng, thay đổi engine gắn nhãn riêng; hiệu ứng ròng chỉ tính khi vượt ngưỡng nhiễu. Bốn cách, chồng lên nhau (theo thiết kế). Một, mỗi lần xuất bản được ghi thành một hành động: URL, ngày, kênh, các câu hỏi nhắm tới; nền tảng tải trang về và xác minh trang đang hoạt động. Hai, sau lần scan theo lịch kế tiếp, báo cáo cho thấy số đo trước và sau theo từng câu hỏi được nhắm tới và từng engine; những câu hỏi không ai nhắm tới đóng vai trò đối chứng, và dao động của chính nền tảng AI hiện ra ở đó. Ba, thay đổi từ phía engine (đổi model, chuyển sang tìm kiếm web) được tuần tra hằng ngày phát hiện, đánh dấu trong báo cáo là thay đổi phương pháp và coi là đường cơ sở mới, không bao giờ tính công cho một hành động nào. Bốn, bằng chứng trực tiếp nhất là trích dẫn: khi engine trích dẫn chính bài bạn đã ghi, việc quy kết không cần suy luận. Cách làm này đã được tính một lần trên panel của một khách hàng: sau khi website đăng các bài trùng tên 8 câu hỏi cốt lõi, tỷ lệ xuất hiện của 8 câu đó trên engine đọc web tăng ròng 37 điểm (đã trừ biến động của 12 câu đối chứng), còn các engine trả lời từ bộ nhớ huấn luyện là 0; 2.000 lần rút ngẫu nhiên câu đối chứng làm giả dược cho thấy ngưỡng nhiễu của các engine tìm kiếm khoảng 17 điểm, hiệu ứng ròng phải vượt ngưỡng đó mới được tính (đo được, 8–9/2026). Trên panel cố định, tỷ lệ xuất hiện tổng thể của các engine trả lời từ bộ nhớ huấn luyện không đổi suốt 12 tuần; thứ dao động là các engine tìm kiếm (đo được). Về PR và quảng cáo: engine AI không thấy màn hình hay vị trí quảng cáo, chỉ thấy trang web, nên chúng chỉ có thể đi vào câu trả lời qua các trang đưa tin, và việc ghi theo kênh giúp tách bạch (theo thiết kế). Con số thuần (nhóm tác động trừ nhóm đối chứng) hiện được tính thủ công; đưa tự động vào báo cáo đang nằm trong lộ trình (lộ trình).
Các nền tảng AI bắt đầu bán quảng cáo, có còn cần GEO không?
Một câu: vị trí trả phí mua chỗ bên cạnh câu trả lời, GEO làm việc với chính câu trả lời; số đo của chúng tôi chỉ gồm hiện diện tự nhiên. Vẫn cần, và càng cần hơn khi vị trí trả phí xuất hiện. Hiện trạng: ChatGPT thử nghiệm vị trí tài trợ dưới câu trả lời cho người dùng Free và Go tại Mỹ từ tháng 2/2026, OpenAI nói chúng không ảnh hưởng câu trả lời; quảng cáo trong Google AI Overview đã chạy ở 12 nước tiếng Anh (có Indonesia, Malaysia, Philippines, Singapore; chưa có Việt Nam và Thái Lan), nhà quảng cáo không thể từ chối hay nhắm chọn vị trí; Perplexity rút khỏi quảng cáo tháng 2/2026; Claude cam kết không quảng cáo; ứng dụng Gemini chưa có quảng cáo (tài liệu nhà cung cấp, đến tháng 11/2026). Vị trí trả phí là nội dung được gắn nhãn tài trợ, tính tiền theo lượt hiển thị, ngừng ngân sách là biến mất, và nó không thay đổi việc AI gợi ý ai hay trích dẫn ai trong phần thân câu trả lời (tài liệu nhà cung cấp và theo thiết kế). GEO làm việc với chính phần thân đó: được nêu tên, được nói đúng, được trích dẫn, tích lũy trên nhiều engine và không lên xuống theo ngân sách. Quan hệ giữa hai bên giống SEO và SEM trong tìm kiếm; vị trí trả phí được bán ngay cạnh câu trả lời tự nhiên. Về đo lường, scan của chúng tôi đọc câu trả lời qua giao diện lập trình của engine, nơi không có các ô quảng cáo dành cho người tiêu dùng, nên số đo mặc nhiên là hiện diện tự nhiên (theo thiết kế); nếu một ngày nền tảng nào mở hiển thị trả phí cho việc đo, chúng tôi sẽ báo cáo thành một cột riêng và không bao giờ trộn vào số đo tự nhiên (lộ trình). Hiện báo cáo chỉ có hiện diện tự nhiên, và ghi rõ như vậy.
Làm sao ngăn AI bịa dữ kiện?
Agent nội dung chỉ được dùng số liệu từ hồ sơ thương hiệu và tài liệu bạn tải lên; số không có nguồn thành chỗ trống để bạn điền. Tên miền đối thủ và nhà cung cấp bị loại khỏi mục tiêu đăng tải, từ dịch cứng được viết lại theo cách nói thị trường, tuyên bố không nguồn bị gắn cờ, và chúng tôi không đăng gì thay bạn — bạn đăng, rồi ghi hành động, chúng tôi xác minh.
Tiêu chuẩn đo lường là gì?
Một tài liệu công khai (v1.1, tháng 9/2026) định nghĩa mọi chỉ số, thiết kế lấy mẫu, nhãn độ tin cậy, độ phủ trích dẫn (4/5 engine), đối chiếu với trang công khai của khách hàng, xác minh hành động đã ghi và quy tắc công bố danh sách nguồn. Mọi con số nền tảng hiển thị đều truy được về đó. Đọc tiêu chuẩn →
Những AI engine và thị trường nào được bao phủ?
ChatGPT, Gemini, Perplexity, Claude và trang Google AI Overview thật, định vị theo khu vực. Thị trường: Việt Nam, Thái Lan, Indonesia, Malaysia, Singapore và Philippines bằng ngôn ngữ địa phương, cùng Hoa Kỳ theo từng bang (hạng nhất: California, Texas, Florida, New York), kèm khung luật bang cho ngành có quản lý.
Tính phí thế nào?
Ba gói theo thương hiệu × thị trường: Starter US$99, Growth US$199 và Scale US$1,999+ mỗi tháng. Gói quyết định nhịp quét định kỳ, quy mô bộ câu hỏi, số engine, số dự án, tần suất báo cáo và credit kèm theo; quét và báo cáo định kỳ đã bao gồm. Credit chỉ trả cho lần chạy bạn tự kích hoạt. Không giới hạn tài khoản; đối tác agency có workspace riêng cho từng khách và giá sỉ. Gói, credit và hạng mục dịch vụ →
Dữ liệu thuộc về ai — và phản hồi thuộc về ai?
Dữ kiện thương hiệu, nhãn hiệu và tài liệu của bạn thuộc về bạn; nền tảng, phương pháp bộ câu hỏi và quy tắc chấm điểm thuộc về chúng tôi. Mỗi lần đội bạn sửa — gắn lại nhãn đối thủ, viết lại câu hỏi, ghi hành động — đều được lưu kèm lý do và dùng lại, nên phản hồi trở thành tài sản của dự án. Bạn xuất được toàn bộ lịch sử trong 12 tháng sau khi chấm dứt, và mọi con số chúng tôi công bố đến từ ít nhất 5 thương hiệu, đã ẩn danh.
MemeCMO dành cho ai?
Thương hiệu vào Đông Nam Á — đặc biệt là doanh nghiệp Trung Quốc ra toàn cầu — thương hiệu khu vực bảo vệ thị trường nhà, thương hiệu Mỹ trong ngành có quản lý nơi câu trả lời khác nhau theo bang, và các agency, nhóm truyền thông phục vụ họ với tư cách đối tác kênh.
MemeCMO khác Semrush, Profound hay các công cụ GEO khác thế nào?
Hầu hết công cụ GEO dừng ở một bảng điều khiển. MemeCMO đi thêm ba bước. Thứ nhất, mười agent tạo ra sản phẩm bàn giao — câu trả lời chuẩn, JSON-LD, nội dung lấp khoảng trống, đăng tải, bản thảo bách khoa — chỉ từ dữ kiện công khai của bạn. Thứ hai, phần phân tích đi xa hơn điểm số: phân loại engine theo việc chúng có đọc web hay không, tải và lập hồ sơ các trang được trích dẫn, đối chiếu câu trả lời của AI với chính website của bạn, và đo mọi hành động so với những câu hỏi bạn không tác động. Thứ ba, mọi con số đều theo một tiêu chuẩn đo lường công khai, bằng các ngôn ngữ Đông Nam Á và theo từng bang tại Hoa Kỳ. Bảng so sánh đầy đủ kèm nguồn →
LIÊN HỆ

Câu đầu tiên của thương hiệu trong cuộc trò chuyện với AI —
bạn quyết định nó nói gì.

Yêu cầu truy cập nền tảng hoặc trao đổi hợp tác. Cho chúng tôi biết thương hiệu và thị trường; chúng tôi sẽ chạy quét cơ sở và cùng bạn đọc kết quả.

EMAIL
TRỤ SỞ
Hồng Kông · hoạt động khắp Đông Nam Á và Hoa Kỳ

Yêu cầu truy cập

Chúng tôi phản hồi trong 24 giờ.