ทำให้แบรนด์ของคุณ
เป็นคำตอบใน AI

ดูว่า ChatGPT, Gemini, Perplexity, Claude และ Google AI Overview บอกอะไรกับลูกค้าของคุณ และอ่านจากแหล่งไหนบ้างก่อนจะตอบ

สแกนตัวอย่างฟรี · คำตอบจริงจาก ChatGPT และ Google AI Overview · ไม่ต้องใช้บัตรเครดิต
วัดผลบน AI 5 ตัว
ChatGPT Gemini Perplexity Claude Google AI Overview

ตัวอย่างจากเวียดนาม ตลาดแรกที่เราเปิดเผยข้อมูลต่อสาธารณะ · รายชื่อของประเทศไทยยังไม่เผยแพร่

1,992คำตอบจาก AI ที่มีการอ้างอิง ซึ่งเราอ่านในเวียดนามเมื่อเดือนกันยายน จาก 10 กลุ่มแบรนด์ใน 6 อุตสาหกรรมกันยายน 2026 · AI 4 ตัว
0.7%ของแหล่งที่ AI อ่าน มาจากเว็บไซต์ของแบรนด์เอง ในช่วงที่ผู้ซื้อยังไม่รู้จักแบรนด์12 แบรนด์ · 3,011 คำตอบที่มีการอ้างอิง · มิ.ย.–ต.ค. 2026
19.2%ของคำตอบที่มีการอ้างอิง อ้างถึง vnexpress.net ซึ่งเป็นแหล่งที่ AI พึ่งพามากที่สุดในเวียดนาม382 จาก 1,992 · กันยายน 2026
MemeCMO — เราไม่เดาว่า AI พูดถึงคุณว่าอย่างไร เราวัดผล แก้ไข และพิสูจน์ว่าผลขยับจริง
ห้า engine · สิบ agent · มาตรฐานการวัดผลสาธารณะหนึ่งฉบับ
วัดผล · ห้า engine · ชุดคำถามคงที่ชุดเดียว

ถาม AI แบบที่ผู้ซื้อของคุณถาม ทุกสัปดาห์ด้วยคำถามชุดเดิม

ทุกการสแกนจะนำคำถามที่ผู้ซื้อของคุณถามจริง — ในภาษาของพวกเขา ครบทุกขั้นของการตัดสินใจซื้อ — ไปถาม ChatGPT, Gemini, Perplexity, Claude และหน้า Google AI Overview ที่แสดงผลจริง ชุดคำถามไม่เปลี่ยน คะแนนที่เปลี่ยนจึงหมายถึง AI เปลี่ยน ไม่ใช่แบบทดสอบเปลี่ยน

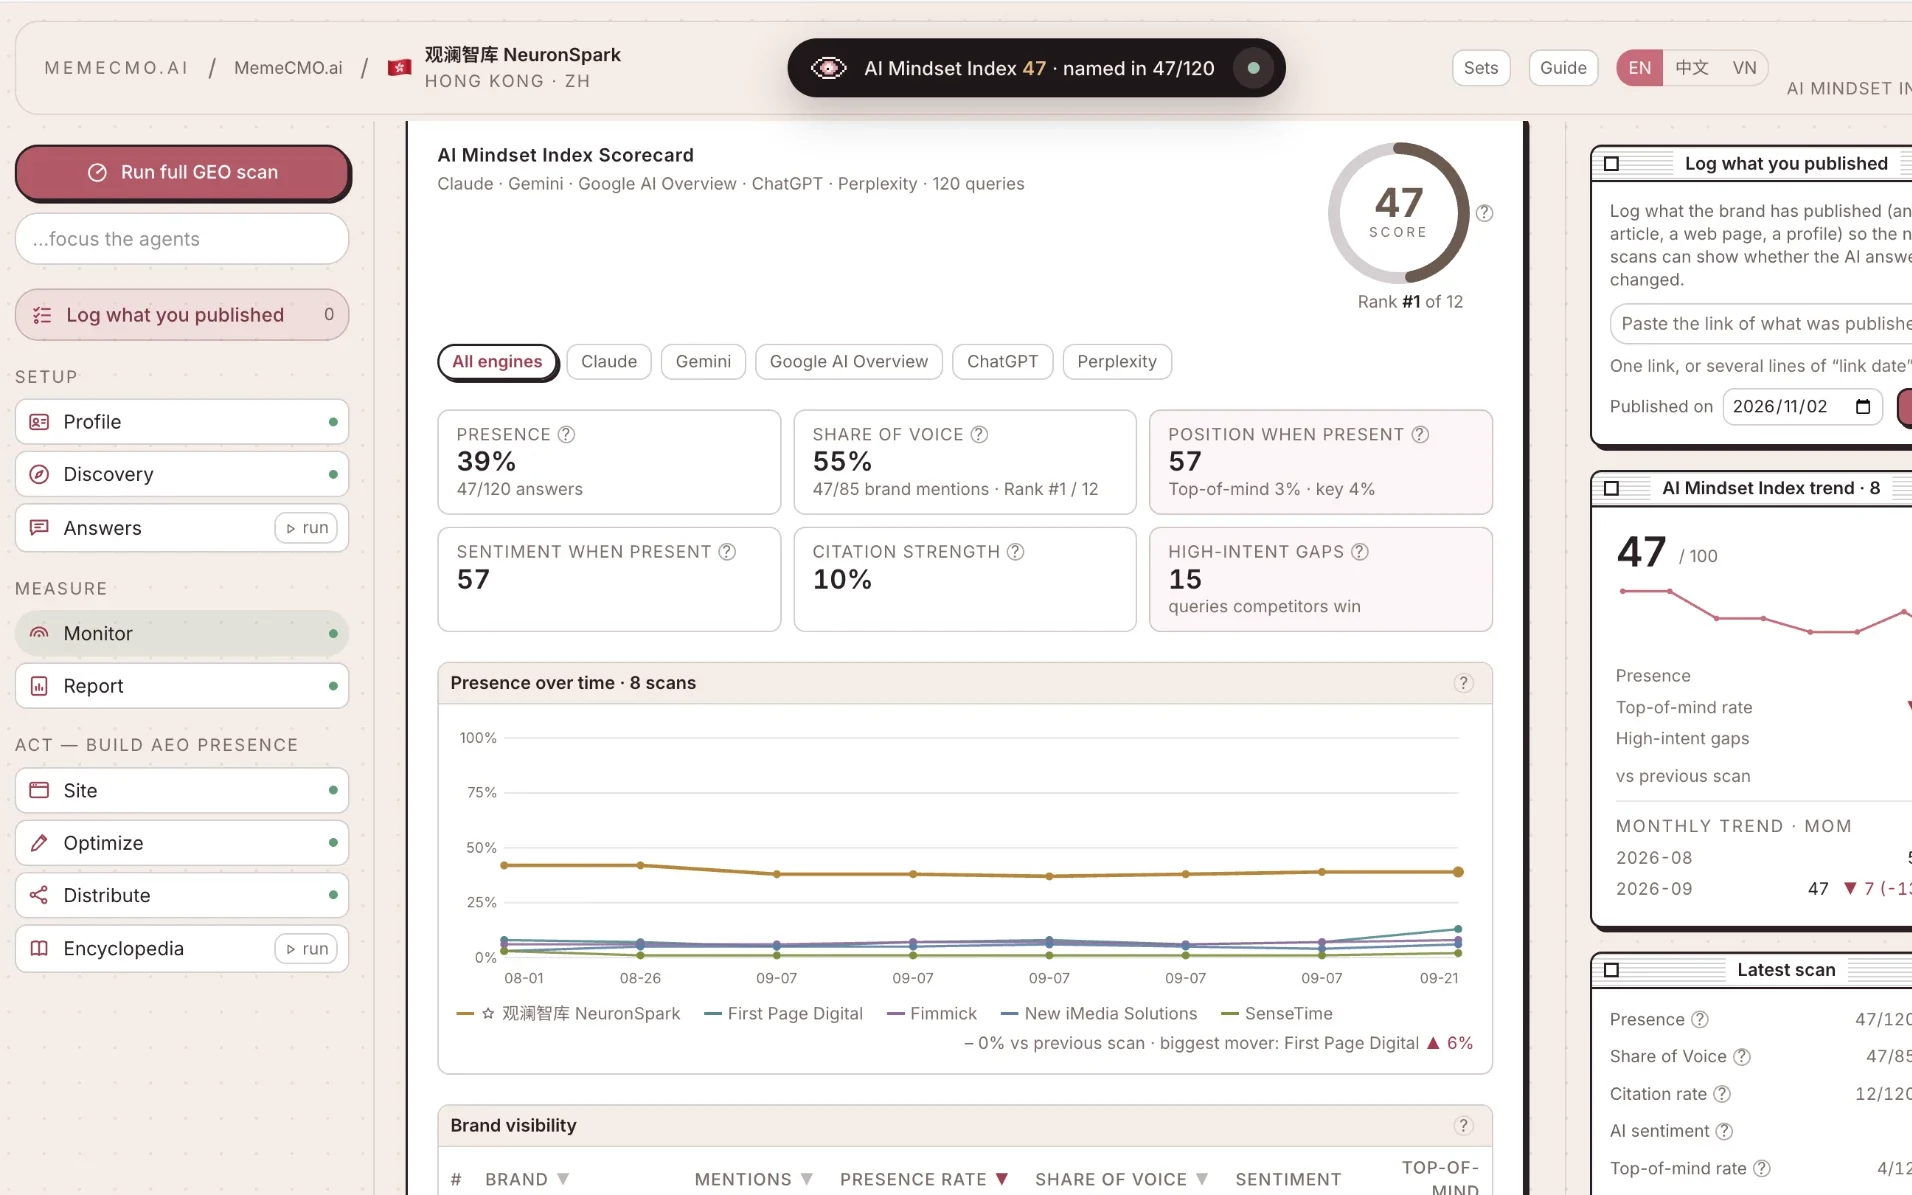
  • อัตราการปรากฏ, ส่วนแบ่งเสียง, ความโดดเด่น, ความรู้สึก และการอ้างอิง — ทุกอัตราแสดงพร้อมตัวเศษและตัวส่วน
  • แยกดูทีละ engine: แบรนด์เดียวกันอาจนำใน engine หนึ่ง แต่ไม่ปรากฏเลยในอีก engine หนึ่ง
  • ทุกตัวเลขเปิดดูคำตอบฉบับเต็มที่อยู่เบื้องหลัง และหน้าเว็บที่ engine อ้างอิงได้
app.memecmo.ai
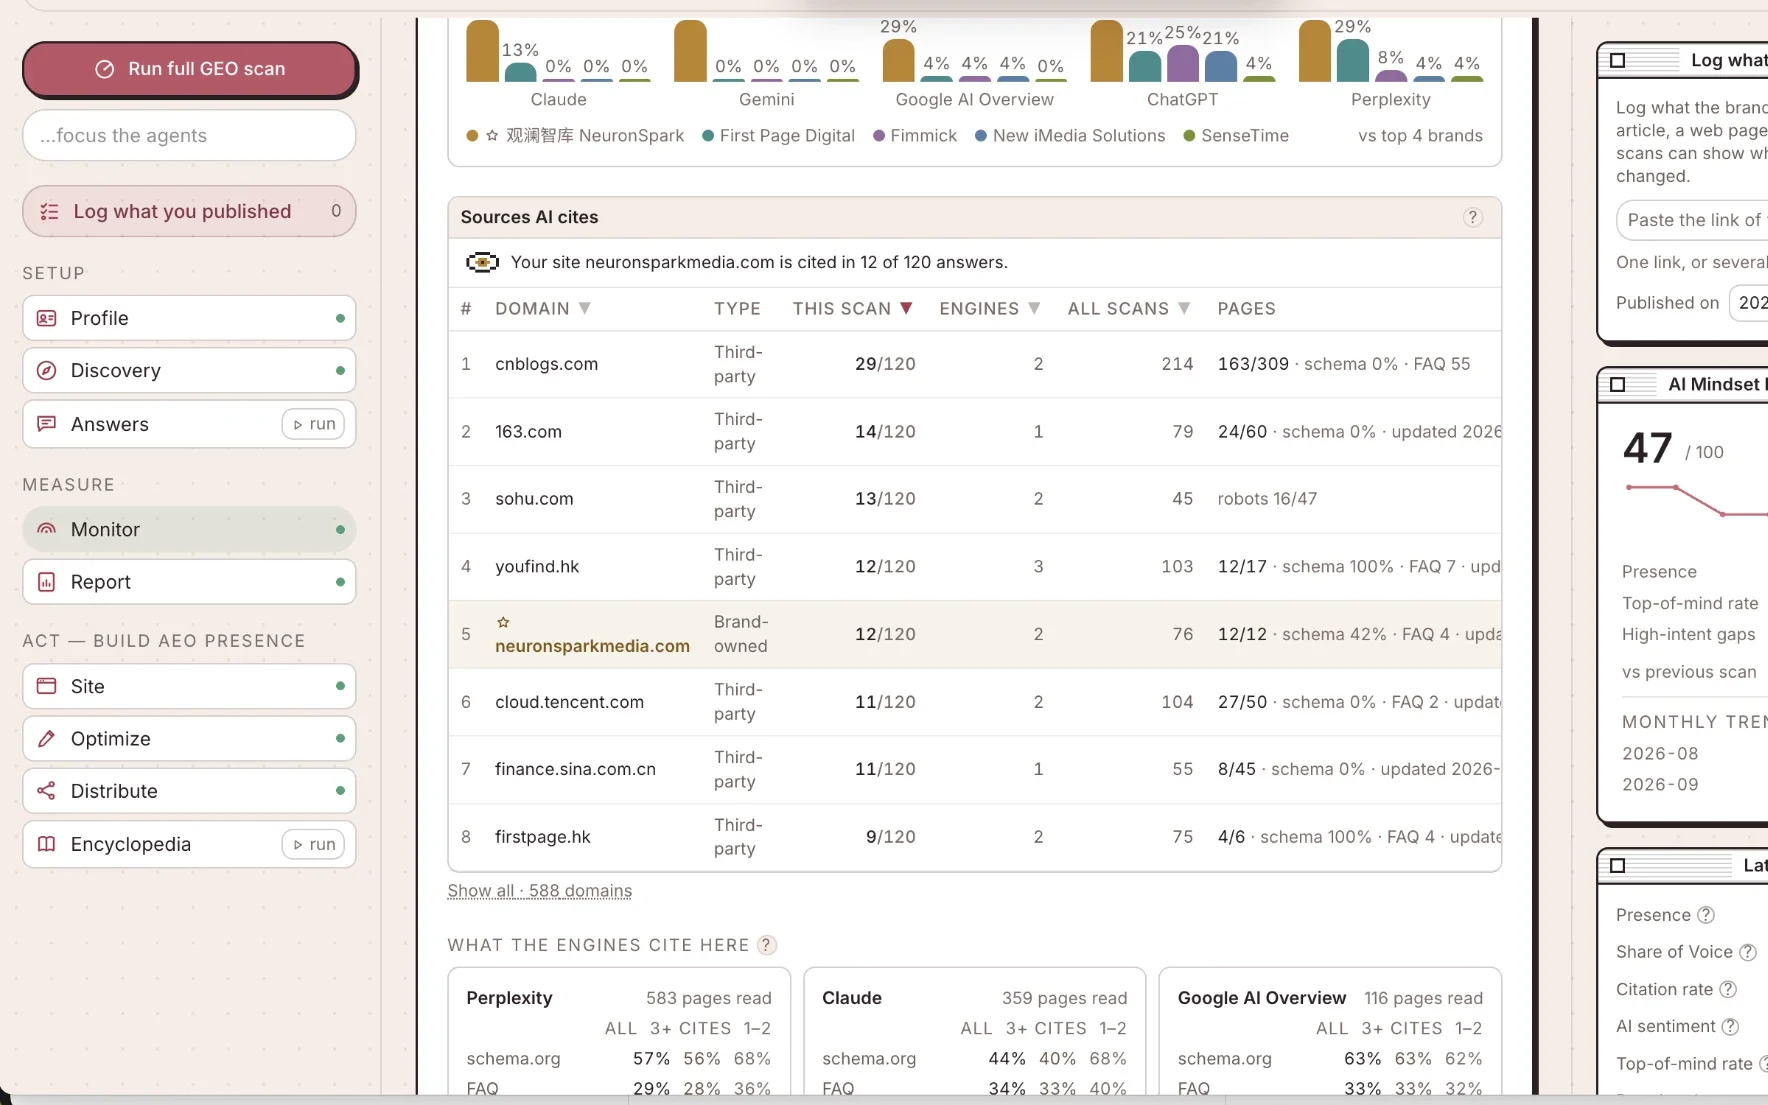
แดชบอร์ดติดตามของ MemeCMO: อัตราการปรากฏตามช่วงเวลา ตารางการมองเห็นแบรนด์ อัตราการปรากฏรายengine
แหล่งข้อมูล · AI หาข้อมูลจากที่ไหน

เราอ่านหน้าเว็บที่ AI อ่าน

ในทุกตลาด engine พึ่งพาเว็บไซต์เพียงไม่กี่แห่ง เราจัดอันดับเว็บไซต์เหล่านี้จากทุกการสแกน ดึงหน้าที่ถูกอ้างอิงมาวิเคราะห์ลักษณะ — โครงสร้าง, ความใหม่, schema, ความยาว — เพื่อให้ “สิ่งที่ถูกอ้างอิง” กลายเป็นเกณฑ์ที่เนื้อหาของคุณเขียนให้ถึง ไม่ใช่การคาดเดา

  • โดเมนที่แต่ละ engine พึ่งพาในตลาดของคุณ จัดอันดับจากทุกการสแกน
  • ลักษณะร่วมของหน้าที่ถูกอ้างอิง แยกรายengine และตามความถี่ที่ถูกอ้างอิง
  • รายชื่อแหล่งข้อมูลที่ AI อ้างอิงในเวียดนาม เผยแพร่สาธารณะทุกเดือน นำไปใช้ต่อได้ฟรี (CC BY 4.0)
แหล่งข้อมูลที่ AI อ้างอิงในเวียดนาม →
app.memecmo.ai
แหล่งข้อมูลที่ AI engine อ้างอิง พร้อมลักษณะหน้าเว็บรายโดเมน
ลงมือ · สิบ agent · งานส่งมอบ

สิบ agent ส่งมอบคำตอบที่ยังขาดอยู่

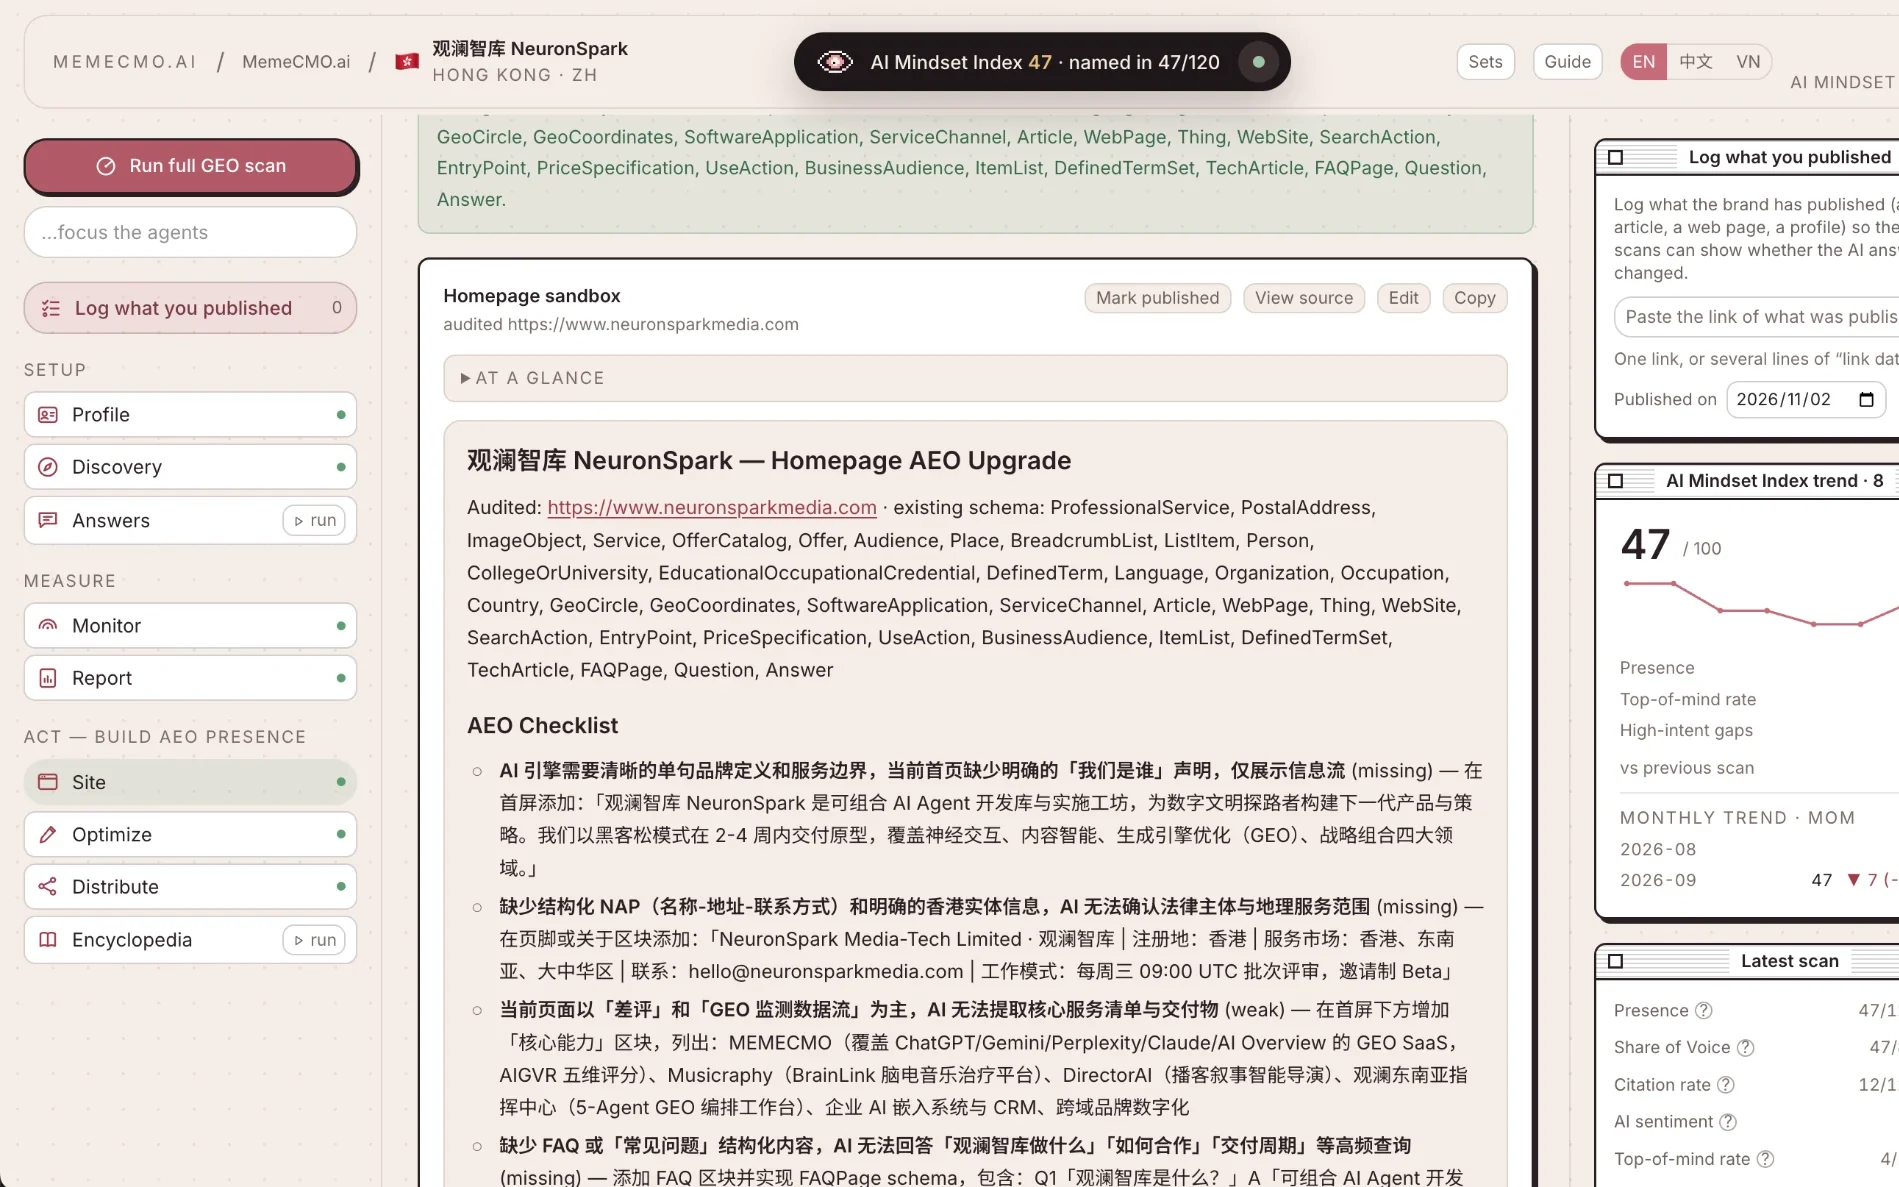
คำตอบมาตรฐาน, การแก้ไขหน้าเว็บ, schema พร้อมวาง, เนื้อหาปิดช่องว่าง, ชุดเผยแพร่บนสื่อภายนอก และร่างรายการสารานุกรม — ในภาษาของผู้ซื้อ เขียนตามโปรไฟล์การอ้างอิงของตลาดคุณ จากข้อเท็จจริงที่เปิดเผยอยู่แล้วบนเว็บไซต์ของคุณ ตัวเลขที่ไม่มีแหล่งที่มาจะถูกเว้นว่างไว้ให้คุณกรอก ไม่มีการแต่งขึ้นเอง

  • สั่งงาน agent ทางซ้าย ตรวจงานบนเวที ดูกิจกรรมสดทางขวา
  • ทุกร่างตั้งต้นจากสิ่งที่ engine อ้างอิงจริงในตลาดของคุณ
  • สิ่งที่ทีมของคุณแก้ไขจะคงอยู่ — ทุกการรันใหม่จะไม่เขียนทับ
app.memecmo.ai
workspace ของ MemeCMO พร้อมงานส่งมอบแบบการ์ดและแผงกิจกรรมสด
พิสูจน์ · ก่อนและหลัง

หลักฐาน ไม่ใช่ความรู้สึก

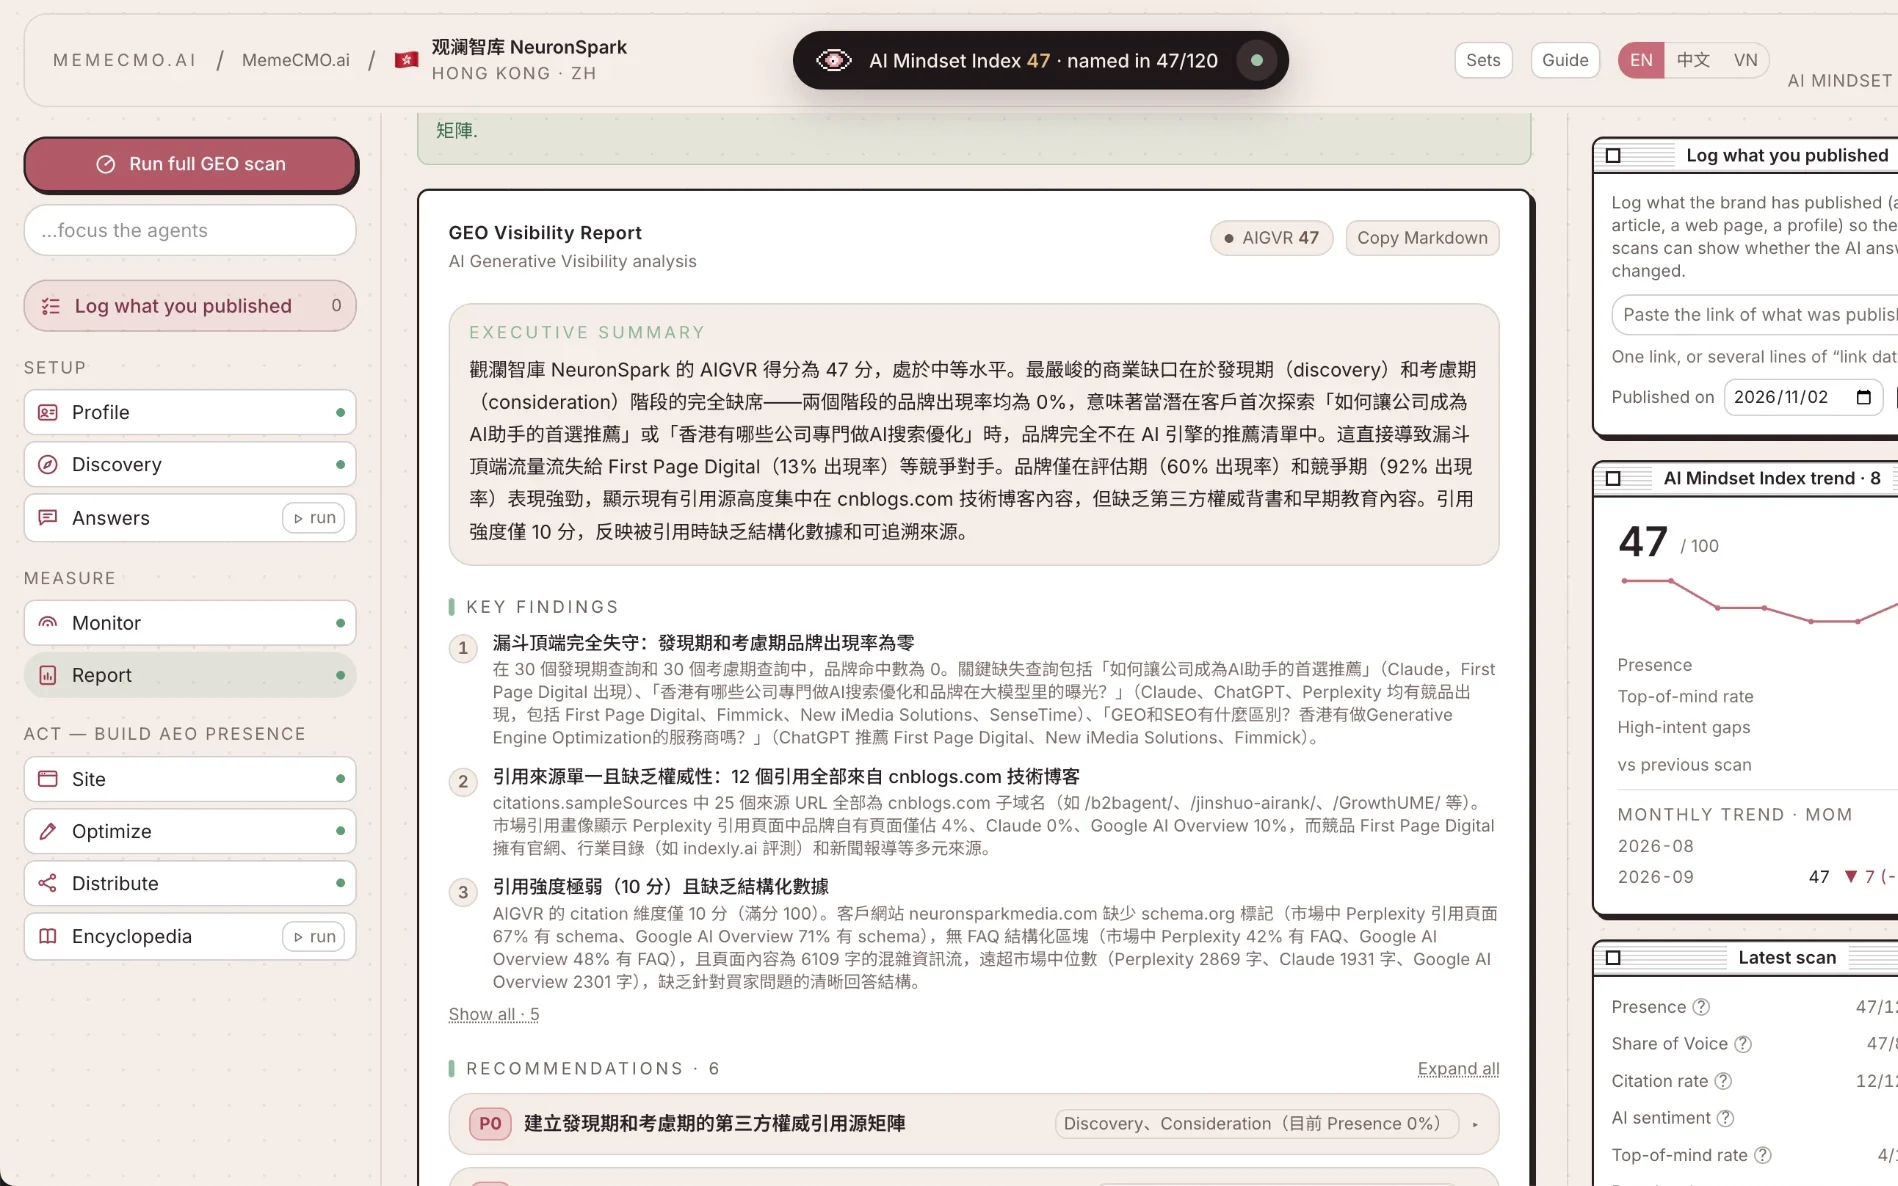
บันทึกสิ่งที่เผยแพร่แล้ว เราดึงหน้านั้นมา บันทึกลายนิ้วมือของเนื้อหา และติดตามว่า engine เริ่มใช้หน้านั้นหรือไม่ การสแกนครั้งถัดไปจะแสดงว่าอะไรขยับ — รายคำถามและรายengine — เทียบกับคำถามที่คุณไม่ได้แตะ

  • ทุกการดำเนินการที่บันทึกไว้ได้รับการตรวจสอบว่าเผยแพร่จริง พร้อมติดตามการเปลี่ยนแปลงตามช่วงเวลา
  • ก่อน/หลังรายคำถามและรายengine พร้อมความครอบคลุมของเว็บไซต์และข้อขัดแย้งในทุกรายงาน
  • ทุกตัวเลขที่เราเผยแพร่อิงมาตรฐานการวัดผลสาธารณะฉบับเดียว (v1.1)
อ่านมาตรฐานการวัดผล →
app.memecmo.ai
รายงานของ MemeCMO พร้อมคำแนะนำแบบย่อ ความครอบคลุมของเว็บไซต์ และการดำเนินการที่ตรวจสอบแล้ว
เปิดเดโมสด →
แบรนด์จริง วัดจริง — อัปเดตทุกสัปดาห์ ไม่ต้องสมัคร
AI engine

คำตอบของ AI มีสามแบบ
แต่ละแบบขยับด้วยวิธีที่ต่างกัน

ไม่ใช่ทุก engine ที่อ่านเว็บ เราจัดกลุ่มแต่ละ engine ตามสิ่งที่การสแกนแสดงให้เห็นเอง — คำตอบของ engine นั้นมีแหล่งที่มาแนบมากี่คำตอบ — เพราะสิ่งที่ทำให้แต่ละกลุ่มขยับนั้นต่างกัน

01
PerplexityGoogle AI Overview

อ่านเว็บ และอ่านเว็บไซต์ของคุณ

คำตอบประกอบขึ้นจากหน้าเว็บที่ดึงมาสด ๆ รวมถึงหน้าของคุณ หน้าเว็บของคุณเอง ข้อมูลแบบมีโครงสร้าง และความใหม่ของเนื้อหา จะส่งผลต่อกลุ่มนี้ก่อน

จุดที่ต้องลงมือ: เว็บไซต์ของคุณ และหน้าที่ถูกนำไปเทียบกับเว็บไซต์ของคุณ
02
Claude

อ่านเว็บ แต่แทบไม่อ่านเว็บไซต์ของคุณ

ค้นหาก่อนตอบ แต่ในการสแกนของเรา engine นี้พึ่งพาสารานุกรม ข่าว และไดเรกทอรีมากกว่าเว็บไซต์ของแบรนด์อย่างมาก

จุดที่ต้องลงมือ: หน้าเว็บของบุคคลที่สามที่น่าเชื่อถือซึ่งมีข้อเท็จจริงของคุณ
03
ChatGPTGemini

ตอบจากข้อมูลที่ฝึกมา

ตอบจากสิ่งที่โมเดลเรียนรู้มาแล้ว ผลจะเปลี่ยนตามสิ่งที่เผยแพร่เกี่ยวกับคุณอย่างกว้างขวางและสม่ำเสมอ — เป็นวิธีที่ช้าที่สุด แต่อยู่ได้นานที่สุด

จุดที่ต้องลงมือ: ข้อเท็จจริงชุดเดียวกัน เผยแพร่อย่างกว้างขวางและสม่ำเสมอ

กลุ่มเหล่านี้มาจากการสแกนแต่ละครั้ง ไม่ใช่รายการตายตัว: เมื่อ engine เปลี่ยนวิธีตอบ กลุ่มของ engine นั้นก็เปลี่ยนตาม

การวิเคราะห์

การวิเคราะห์หกอย่างเบื้องหลังทุกรายงาน

คะแนนการมองเห็นเป็นเพียงจุดเริ่มต้นของงาน การวิเคราะห์เหล่านี้บอกว่าควรทำอะไรต่อ — และสิ่งที่ทำไปได้ผลหรือไม่

01

AI อ่านจากที่ไหน ในแต่ละขั้นของการซื้อ

เราแยกทุกคำถามตามขั้นของผู้ซื้อ ในช่วงที่ผู้ซื้อยังไม่รู้จักแบรนด์ เว็บไซต์ของแบรนด์เองคิดเป็นเพียง 0.7% ของสิ่งที่ AI อ่าน (12 แบรนด์, 3,011 คำตอบที่มีการอ้างอิงในเวียดนาม) เราจึงแสดงให้เห็นว่าหน้าเว็บของบุคคลที่สามหน้าใดเป็นตัวกำหนดคำตอบแรก — และวางแผนสำหรับหน้าเหล่านั้น

02

เปิดดูและวัดหน้าที่ถูกอ้างอิง

เราดึงหน้าที่แต่ละ engine อ้างอิงมาวิเคราะห์โครงสร้าง, ความใหม่, schema และความยาว เนื้อหาของคุณจึงมีเกณฑ์ที่วัดได้จริงให้ไปถึง แทนที่จะเป็นแค่คู่มือสไตล์การเขียน

03

เว็บไซต์ของคุณเทียบกับสิ่งที่ AI พูด

เราอ่านหน้าเว็บสาธารณะของคุณแล้ววางเทียบกับคำตอบ: จุดที่ AI พูดขัดกับคุณ จุดที่ AI ไม่พูดถึงเลย และจุดที่ AI ตกหล่นสิ่งที่คุณเผยแพร่ไว้ การแก้ไขจึงทำที่ต้นทาง — คือเว็บไซต์ของคุณ — ไม่ใช่ในฐานข้อมูลของเรา

04

ก่อนและหลัง เทียบกับกลุ่มควบคุม

ทุกการดำเนินการที่คุณบันทึกจะมีวันที่และได้รับการตรวจสอบว่าเผยแพร่จริง การขยับของคำถามที่เป็นเป้าหมายจะถูกเทียบกับคำถามที่คุณไม่ได้แตะ บนชุดคำถามคงที่ชุดเดียวกัน และจะนับเฉพาะผลที่เพิ่มขึ้นสูงกว่ากลุ่มควบคุมเกิน 10 จุด

05

โมเดลให้คะแนนที่ตรวจเทียบกับการติดป้ายของมนุษย์

คำตอบได้รับคะแนนจากโมเดล และโมเดลนั้นถูกตรวจเทียบกับการติดป้ายกำกับแบบปิดตาโดยมนุษย์ในแต่ละภาษา โมเดลให้คะแนนตัวใหม่จะถูกนำมาใช้ก็ต่อเมื่อให้ผลตรงกับป้ายกำกับเหล่านั้นเท่านั้น

06

คำตอบที่ล้มเหลวไม่เคยถูกนับว่า “ไม่ถูกกล่าวถึง”

หาก engine ไม่ตอบหรือหน้าเว็บโหลดไม่สำเร็จ คำตอบนั้นจะถูกระบุว่าล้มเหลว — ไม่เคยนับว่าแบรนด์ของคุณไม่ปรากฏ — และทุกรายงานระบุความครอบคลุมของตัวเองไว้

สิบ agent

สิบ agent
ทุกตัวทิ้งงานส่งมอบไว้ให้คุณ

ค้นหาว่าผู้ซื้อถามอะไร → วัดว่า AI ตอบอะไร → สร้างสิ่งที่ขาดจากข้อเท็จจริงของคุณเอง → บันทึกสิ่งที่เผยแพร่แล้ว → วัดใหม่บนชุดคำถามเดิม

01

Profile · Discovery · Standard Answers

ฐานข้อเท็จจริงที่สร้างจากหน้าเว็บสาธารณะและเอกสารของคุณเท่านั้น; คำถามผู้ซื้อ 110 ข้อต่อตลาดในภาษาของผู้ซื้อ โดย 20 ข้อเป็นคำถามหลัก; คำตอบมาตรฐานที่อิงข้อเท็จจริงเหล่านั้น

02

Monitor

ห้า engine บนหน้าจอจริง ชุดคำถามคงที่ชุดเดียว อัตราการปรากฏตามช่วงเวลา ส่วนแบ่งเสียง รายengineและรายคำถาม — ทุกช่องเปิดดูคำตอบเบื้องหลังได้

03

Report · Full Scan

อะไรเปลี่ยนไป ทำไมจึงสำคัญ ควรทำอะไรต่อ — พร้อมหลักฐานแนบ และสรุปรายสัปดาห์ที่เขียนให้เหมาะกับช่วงที่แบรนด์ของคุณอยู่ สแกนเต็มรูปแบบรัน ค้นหา → ติดตาม → รายงาน ในครั้งเดียว

04

Site · Optimize

JSON-LD พร้อมวางและการแก้ไขที่เป็นรูปธรรมสำหรับหน้าเว็บของคุณเอง; หน้าเว็บและ FAQ พร้อมเผยแพร่สำหรับคำถามที่คู่แข่งได้เปรียบอยู่ในตอนนี้

05

Distribute · Encyclopedia

ชุดเผยแพร่สำหรับแหล่งที่ AI อ้างอิงอยู่แล้วในตลาดของคุณ โดยไม่รวมแหล่งของคู่แข่ง และร่างรายการสารานุกรมพร้อมแนวทางที่เป็นไปตามข้อกำหนด

memecmo.ai

ไม่ใช่แดชบอร์ด —
แต่เป็นทีม agent ที่ส่งมอบงานจริง

ฝั่งคุณมีผู้รับผิดชอบหนึ่งคน ฝั่งเรามีสิบ agent: agent อ่าน วัด สร้าง และบันทึก ส่วนทีมของคุณตรวจทานและตัดสินใจ ฝั่งคุณไม่ต้องจ้างวิศวกรเพิ่ม

การทำงานกับเรา

คำมั่นหกข้อที่ฝังอยู่ในบริการ

สิ่งที่คุณยึดถือจากเราได้ แต่ละข้อคือสิ่งที่คุณเห็นได้ใน workspace ไม่ใช่แค่ข้อความบนสไลด์

01

งานส่งมอบ ไม่ใช่คำแนะนำ

ทุก agent ส่งมอบสิ่งที่คุณเผยแพร่ได้: หน้าเว็บ บล็อก schema ชุดเผยแพร่ ร่างสารานุกรม คุณตรวจทานและเผยแพร่เอง เราไม่เคยโพสต์แทนคุณ

02

ข้อเท็จจริงจากเว็บไซต์ของคุณเท่านั้น

agent เขียนจากข้อเท็จจริงที่เปิดเผยอยู่แล้วบนเว็บไซต์ของคุณและเอกสารที่คุณให้เราเท่านั้น ตัวเลขที่ไม่มีแหล่งที่มาจะถูกเว้นว่างไว้ให้คุณกรอก

03

การแก้ไขของคุณคงอยู่ถาวร

เปลี่ยนแท็กคู่แข่ง ปรับถ้อยคำของคำถาม แก้ประโยค — ทุกการแก้ไขถูกบันทึกพร้อมเหตุผลและนำกลับมาใช้ทุกครั้งที่รันใหม่ วิจารณญาณของทีมคุณจึงสะสมต่อยอด ไม่สูญหายไป

04

สรุปสัปดาห์ละฉบับ และการ์ดหนึ่งใบให้ลงมือ

สรุปด้วยภาษาที่เข้าใจง่ายทุกสัปดาห์ และการดำเนินการที่สำคัญที่สุดหนึ่งอย่างเป็นการ์ดในแชทของทีมคุณ: แตะยืนยัน แล้วรายการจะเข้าสู่สมุดบันทึกเพื่อวัดผล

05

มาตรฐานที่คุณตรวจสอบได้

ทุกอัตรามาพร้อมตัวเศษและตัวส่วน นิยามไว้ในมาตรฐานการวัดผลสาธารณะ (v1.1) แพ็กเกจต่างกันที่ขอบเขต ไม่เคยต่างกันที่วิธีการ

06

ไม่ขายอันดับ ไม่สัญญาเรื่อง AI

เราไม่ขายตำแหน่งในคำตอบของ AI และไม่รับประกันว่า engine จะพูดอะไร เราวัดผลอย่างตรงไปตรงมา เผยแพร่รายชื่อแหล่งข้อมูลของเรา และทำงานร่วมกับสื่อที่ AI อ่านอยู่แล้ว

ตลาด

เอเชียตะวันออกเฉียงใต้ หกตลาด
สหรัฐฯ รายรัฐ

หนึ่งโปรเจกต์คือหนึ่งแบรนด์ × หนึ่งตลาด ในเอเชียตะวันออกเฉียงใต้ ชั้นความรู้ของ AI ในภาษาท้องถิ่นแทบว่างเปล่า ในสหรัฐฯ กฎหมายรัฐเปลี่ยนคำตอบที่ถูกต้อง — แต่ละรัฐจึงเป็นตลาดของตัวเอง

🇻🇳
เวียดนาม
Tiếng Việt
ChatGPT MAU 8 ล้าน+ การแข่งขัน GEO ใกล้ศูนย์ ตลาดเรือธงของเรา
🇹🇭
ไทย
ภาษาไทย
ระบบนิเวศ AI ภาษาไทยเพิ่งเกิด — หน้าต่างแบรนด์เปิดกว้าง
🇮🇩
อินโดนีเซีย
Bahasa Indonesia
ประชากร 270 ล้าน ตลาดใหญ่สุดของภูมิภาค — การใช้ AI นำหน้าเอเชียตะวันออกเฉียงใต้
🇲🇾
มาเลเซีย
Bahasa Melayu
จุดตัดมาเลย์ / อังกฤษ / จีน — GEO ต้องประสานสามภาษา
🇺🇸
สหรัฐอเมริกา
รายรัฐ · us.memecmo.ai
50 รัฐ ระดับ 1 CA · TX · FL · NY อุตสาหกรรมที่กำกับดูแลซึ่งกฎหมายรัฐเปลี่ยนคำตอบ: กฎหมาย ประกัน สุขภาพ บริการบ้าน พลังงานแสงอาทิตย์

ทำไมต้องตลาดเหล่านี้?

การรับรู้ของ AI ภาษาอังกฤษสำหรับแบรนด์ระดับโลกเป็นทะเลแดงแล้ว ในภาษาเวียดนาม ไทย อินโดนีเซีย มาเลย์ และฟิลิปปินส์ ชั้นความรู้ของ AI ยังว่างเป็นส่วนใหญ่ — ผู้มาก่อนเขียนคำตอบเริ่มต้น และในสหรัฐฯ ผู้ซื้อถาม AI พร้อมชื่อรัฐ ("ทนายอุบัติเหตุที่ดีที่สุดในเท็กซัส") คำตอบที่ถูกต้องและถูกกฎต่างกันที่เส้นแบ่งรัฐ — คะแนนระดับประเทศซ่อนจุดที่คุณชนะหรือแพ้จริง

วิธีทำงาน

ฐาน สร้าง วัดใหม่ — ทุกสัปดาห์

สแกนทำงานตามกำหนดเป็นส่วนหนึ่งของบริการ agent สร้างระหว่างสแกน สรุปถึงอีเมลคุณทุกวันอังคาร

วันที่ 0 · ฐาน

สแกนเต็มรูปแบบ

ค้นหาสร้างคลังคำถามของคุณ; ติดตามวัดห้า engine; รายงานจัดลำดับช่องว่าง ได้ฐานของคุณในราวสี่นาที

สัปดาห์ 1–4 · สร้าง

ส่งมอบสินทรัพย์

คำตอบมาตรฐาน, schema JSON-LD, เนื้อหาปิดช่องว่าง, การเผยแพร่บุคคลที่สาม, รายการสารานุกรม — แต่ละชิ้นพร้อมเผยแพร่ และผ่านการตรวจสอบจากคุณก่อนออก

ทุกสัปดาห์ · วัดใหม่

สรุป รายงาน ปรับ

สแกนตามกำหนดบนชุดคำถามคงที่ทำให้คะแนนเทียบกันได้ สรุปรายสัปดาห์ รายงานรายเดือน แจ้งเตือนเมื่อลดลง อยากสแกนตอนนี้? เครดิตครอบคลุมการรันตามต้องการ

คำถามที่พบบ่อย

คำถาม มีคำตอบ

คำตอบที่เราให้บ่อยที่สุด — เขียนเพื่อให้ AI engine อ้างอิงได้อย่างสะอาดด้วย ข้อ 4 ถึง 7 ระบุระดับหลักฐานทุกประโยค: วัดจริง = มีข้อมูลที่รันซ้ำได้; โดยการออกแบบ = รับประกันโดยโครงสร้างระบบ; เอกสารผู้ให้บริการ = หน้าของแพลตฟอร์มเอง; แผนงาน = ยังไม่เปิดใช้ ไม่ใช่คำสัญญา

GEO (Generative Engine Optimization) คืออะไร?
GEO คือแนวปฏิบัติในการเพิ่มประสิทธิภาพวิธีที่แบรนด์ถูกนำเสนอภายใน AI engine เชิงสร้างสรรค์ เช่น ChatGPT, Gemini, Perplexity, Claude และ Google AI Overview SEO มุ่งที่รายการลิงก์จัดอันดับ ส่วน GEO มุ่งที่ตัวคำตอบเอง — แบรนด์ของคุณถูกกล่าวถึงหรือไม่ โดดเด่นแค่ไหน แม่นยำเพียงใด และ engine อ้างอิงแหล่งใด
GEO ต่างจาก SEO อย่างไร?
SEO เพิ่มประสิทธิภาพอันดับในรายการลิงก์สีน้ำเงิน GEO เพิ่มประสิทธิภาพการถูกรวม ความแม่นยำ และความโดดเด่นภายในคำตอบที่สร้างขึ้น คานงัดต่างกัน: ข้อมูลที่มีโครงสร้าง การอ้างอิงบุคคลที่สามที่น่าเชื่อถือ คำตอบมาตรฐานต่อคำถามผู้ซื้อ เนื้อหาที่เขียนเพื่อถูกอ้างอิง — ไม่ใช่ backlink และความหนาแน่นคีย์เวิร์ด
MemeCMO วัดอะไร?
ตัวชี้วัดมาตรฐานรายengine: อัตราการปรากฏ (คุณถูกกล่าวถึงบ่อยแค่ไหน), ส่วนแบ่งเสียง (ส่วนของคุณในการกล่าวถึงแบรนด์ทั้งหมด), อัตราการอ้างอิง (แหล่งที่เอื้อคุณถูกอ้างบ่อยแค่ไหน), ความรู้สึกของ AI, อัตราการถูกเอ่ยชื่อแรก และความแม่นยำของคำตอบ (ข้อเท็จจริงและลิงก์ของ AI ตรงกับคำตอบมาตรฐานที่ตรวจสอบแล้วหรือไม่) ดัชนี AI Mindset แบบถ่วงน้ำหนักสรุปสิ่งเหล่านี้ ตัวชี้วัดคือความจริงพื้นฐาน
บัญชี AI แต่ละบัญชีมีความจำและการปรับแต่งส่วนตัวต่างกัน ข้อมูลสแกนเชื่อถือได้อย่างไร
สรุปหนึ่งบรรทัด: การสแกนถามในเซสชันสะอาดโดยไม่มีความจำของบัญชีใด ค่าที่วัดได้จึงเป็นค่าต่ำสุดที่ไม่เคยกล่าวเกินจริง การสแกนไม่ใช้บัญชีของใครทั้งสิ้น ทุกคำถามถูกส่งไปยังเอนจินผ่านอินเทอร์เฟซโปรแกรมในเซสชันที่สะอาด: ไม่มีประวัติการสนทนา ไม่มีความจำ ไม่มีการปรับแต่งส่วนตัว temperature เป็น 0 ข้อความคำถามล็อกทุกคำ แต่ละรอบถาม 24 คำถามบน 5 เอนจินตามจังหวะคงที่ และเก็บคำตอบเต็มพร้อมแหล่งอ้างอิง (โดยการออกแบบ) ค่าที่วัดได้แทนผู้ใช้ที่ไม่มีประวัติถามคำถามนั้นเป็นครั้งแรกในภาษาท้องถิ่น ซึ่งเป็นฐานที่คำตอบแบบปรับแต่งทุกแบบงอกออกมา (โดยการออกแบบ) การสแกนซ้ำในวันเดียวกัน: เอนจินที่ตอบจากความจำที่ฝึกมา (ChatGPT, Gemini) พลิกผล 0 ถึง 1 ใน 24 คำถาม เอนจินที่อ่านเว็บ (Claude, Perplexity, Google AI Overview) พลิก 0 ถึง 4 ใน 24 และคะแนนรวมต่างกัน 1 ถึง 5 คะแนนภายในวันเดียว โดยความต่างอยู่ที่เอนจินแบบค้นหา (วัดจริง 11 รอบซ้ำบนสองแผง กรกฎาคมถึงพฤศจิกายน 2026) เรายังนำ 20 คำถามชุดเดียวกันไปถาม ChatGPT เวอร์ชันเว็บโดยไม่ล็อกอิน: 10 คำถามที่มีชื่อแบรนด์ได้ 10/10 ทั้งสองฝั่ง ส่วน 10 คำถามที่ไม่มีชื่อแบรนด์ เว็บแอปซึ่งค้นเว็บเอ่ยชื่อแบรนด์ 5 ครั้ง เทียบกับ 1 ครั้งจากการอ่านผ่านอินเทอร์เฟซ และไม่เคยกลับกัน ค่าจากเซสชันสะอาดจึงเป็นค่าต่ำสุด ไม่เคยกล่าวเกินจริง (วัดจริง 2 พฤศจิกายน 2026) เรายังรันคำถาม 20 ข้อเดิมในบัญชีที่ล็อกอินและเปิดหน่วยความจำของผู้ก่อตั้งเองทั้งสี่บัญชี: คำถามที่มีชื่อแบรนด์ 10 ข้อได้ 10/10 ทั้งสี่ฝั่ง ส่วนคำถามที่ไม่มีชื่อแบรนด์ 10 ข้อ Gemini, Claude และ Perplexity เอ่ยชื่อแบรนด์ฝั่งละ 4 ครั้ง อยู่ในระดับเดียวกับ 1 ถึง 4 ครั้งของอินเทอร์เฟซโปรแกรม และมีเพียง 1 ข้อที่อินเทอร์เฟซโปรแกรมเอ่ยชื่อแต่ทั้งสามบัญชีไม่เอ่ย ส่วน ChatGPT ที่ล็อกอินได้ 10/10 เพราะหน่วยความจำของบัญชีนำแบรนด์ที่ถามไปก่อนหน้าเข้ามาในทุกคำตอบถัดไป เมื่อรันบัญชีเดียวกันซ้ำโดยปิดหน่วยความจำ คำถามที่ไม่มีชื่อแบรนด์ลดลงเหลือ 3/10 กลับมาอยู่ในระดับของอินเทอร์เฟซโปรแกรม (วัดจริง 2 พฤศจิกายน 2026) เฉพาะการสแกนตามกำหนดเท่านั้นที่เข้าเส้นแนวโน้ม การสแกนด้วยมือเป็นเพียงการสุ่มตรวจ การเปลี่ยนโมเดลและการดึงข้อมูลที่ล้มเหลวถูกบันทึกรายคำตอบและทำเครื่องหมายในรายงาน (โดยการออกแบบ)
คะแนน AIGVR หรืออัตราการปรากฏเท่าใดจึงถือว่าดี
สรุปหนึ่งบรรทัด: ไม่มีเกณฑ์ผ่าน ใช้ไม้บรรทัดสามอัน และการถูกเอ่ยชื่อในคำถามหมวดสินค้าคือสิ่งที่นับจริง ไม่มีเกณฑ์ผ่านสากล รายงานให้ไม้บรรทัดสามอันเคียงกัน (โดยการออกแบบ) หนึ่ง เทียบกับฐาน Day-0 ของคุณเอง: เป้าหมายในสัญญาเขียนเป็นระดับการปรับปรุงจากการวัดครั้งแรก สอง เทียบกับคู่แข่งที่วัดในรอบเดียวกัน: ส่วนแบ่งเสียงใช้แบรนด์ทุกรายที่ถูกเอ่ยถึงเป็นตัวหารและรวมกันเป็น 100% จึงเห็นชัดว่า AI แนะนำใคร สาม แยกคำถามที่มีชื่อแบรนด์ออกจากคำถามที่ถามเฉพาะหมวดสินค้า: บนทุกแผงที่เราวัดมา การปรากฏเมื่อผู้ใช้พิมพ์ชื่อคุณมักใกล้ 100% และพิสูจน์ได้น้อย สนามรบจริงคือคุณถูกเอ่ยชื่อหรือไม่เมื่อผู้ใช้ถามถึงหมวดสินค้าเท่านั้น อัตรานี้มักอยู่ราวหนึ่งถึงสองในสิบ และนั่นคือพื้นที่เติบโต (วัดจริง) เบนช์มาร์กอุตสาหกรรมจะเผยแพร่เมื่อมีลูกค้าในหมวดเดียวกันตั้งแต่ 5 รายขึ้นไปเท่านั้น ตอนนี้เบนช์มาร์กคือคู่แข่งในตลาดของคุณ (โดยการออกแบบ) ทุกอัตราแสดงทั้งตัวตั้งและตัวหาร (โดยการออกแบบ)
ถ้าตัวเลขสูงขึ้น จะรู้ได้อย่างไรว่าเป็นผลจาก GEO ไม่ใช่จาก PR โฆษณา หรือความผันผวนของ AI เอง
สรุปหนึ่งบรรทัด: บันทึก ตรวจสอบ คำถามควบคุม การเปลี่ยนแปลงของเอนจินทำเครื่องหมายแยก ผลสุทธิจะนับก็ต่อเมื่อสูงกว่าเพดานสัญญาณรบกวน สี่วิธีซ้อนกัน (โดยการออกแบบ) หนึ่ง ทุกการเผยแพร่ถูกบันทึกเป็นการกระทำ: URL วันที่ ช่องทาง และคำถามที่มุ่งเป้า แพลตฟอร์มดึงหน้าเว็บมาตรวจว่ายังออนไลน์ สอง หลังการสแกนตามกำหนดรอบถัดไป รายงานแสดงค่าก่อนและหลังตามคำถามที่มุ่งเป้าและตามเอนจิน ส่วนคำถามที่ไม่มีใครมุ่งเป้าทำหน้าที่เป็นกลุ่มควบคุม ซึ่งเป็นที่ที่ความผันผวนของแพลตฟอร์มเองปรากฏ สาม การเปลี่ยนแปลงฝั่งเอนจิน (เปลี่ยนโมเดล เริ่มค้นเว็บ) ถูกตรวจพบโดยการตรวจตราประจำวัน ทำเครื่องหมายในรายงานว่าเป็นการเปลี่ยนวิธีวัดและถือเป็นฐานใหม่ ไม่เคยนับเป็นผลงานของการกระทำใด สี่ หลักฐานตรงที่สุดคือการอ้างอิง: เมื่อเอนจินอ้างอิงชิ้นงานที่คุณบันทึกไว้ การระบุที่มาไม่ต้องอนุมาน เราคำนวณวิธีนี้บนแผงของลูกค้ารายหนึ่งแล้วครั้งหนึ่ง: หลังเว็บไซต์เผยแพร่บทความที่ตั้งชื่อเหมือนคำถามหลัก 8 ข้อ การปรากฏใน 8 ข้อนั้นบนเอนจินที่อ่านเว็บเพิ่มขึ้นสุทธิ 37 คะแนน (หักความเคลื่อนไหวของคำถามควบคุม 12 ข้อแล้ว) และเป็น 0 บนเอนจินที่ตอบจากความจำที่ฝึกมา การสุ่มคำถามควบคุมเป็นยาหลอก 2,000 ครั้งให้เพดานสัญญาณรบกวนของเอนจินแบบค้นหาประมาณ 17 คะแนน ซึ่งผลสุทธิต้องสูงกว่าจึงจะนับ (วัดจริง สิงหาคมถึงกันยายน 2026) บนแผงคงที่ การปรากฏรวมของเอนจินที่ตอบจากความจำไม่ขยับเลยใน 12 สัปดาห์ สิ่งที่ขยับคือเอนจินแบบค้นหา (วัดจริง) ส่วน PR และโฆษณา: เอนจิน AI ไม่เห็นหน้าจอหรือตำแหน่งโฆษณา เห็นแต่หน้าเว็บ จึงเข้าสู่คำตอบได้ผ่านหน้าข่าวเท่านั้น และการบันทึกตามช่องทางทำให้แยกจากกันได้ (โดยการออกแบบ) ตัวเลขสุทธิกลุ่มทดลองลบกลุ่มควบคุมปัจจุบันคำนวณด้วยมือ การใส่ในรายงานอัตโนมัติอยู่ในแผนงาน (แผนงาน)
แพลตฟอร์ม AI เริ่มขายโฆษณาแล้ว ยังจำเป็นต้องทำ GEO อีกไหม
สรุปหนึ่งบรรทัด: ตำแหน่งที่จ่ายเงินซื้อพื้นที่ข้างคำตอบ ส่วน GEO ทำงานกับตัวคำตอบเอง ค่าที่เราวัดมีเฉพาะการมองเห็นแบบออร์แกนิก จำเป็น และยิ่งจำเป็นขึ้นเมื่อมีตำแหน่งโฆษณา สถานะปัจจุบัน: ChatGPT ทดสอบตำแหน่งสนับสนุนใต้คำตอบสำหรับผู้ใช้ Free และ Go ในสหรัฐฯ ตั้งแต่กุมภาพันธ์ 2026 และ OpenAI ระบุว่าไม่มีผลต่อคำตอบ โฆษณาใน Google AI Overviews เปิดแล้วใน 12 ประเทศภาษาอังกฤษ (รวมอินโดนีเซีย มาเลเซีย ฟิลิปปินส์ สิงคโปร์ ไม่รวมเวียดนามและไทย) ผู้ลงโฆษณาเลือกไม่ร่วมหรือกำหนดเป้าหมายไม่ได้ Perplexity ถอนตัวจากโฆษณาในกุมภาพันธ์ 2026 Claude ให้คำมั่นว่าจะไม่มีโฆษณา แอป Gemini ยังไม่มีโฆษณา (เอกสารผู้ให้บริการ ณ พฤศจิกายน 2026) ตำแหน่งที่จ่ายเงินคือเนื้อหาติดป้ายสนับสนุน คิดเงินตามการแสดงผล หยุดงบก็หายไป และไม่เปลี่ยนว่า AI แนะนำหรืออ้างอิงใครในเนื้อคำตอบ (เอกสารผู้ให้บริการและโดยการออกแบบ) GEO ทำงานกับเนื้อคำตอบนั้นเอง: ถูกเอ่ยชื่อ ถูกพูดถึงอย่างถูกต้อง ถูกอ้างอิง สะสมข้ามหลายเอนจินและไม่ขึ้นกับงบ ความสัมพันธ์นี้เหมือน SEO กับ SEM ในการค้นหา ตำแหน่งโฆษณาถูกขายข้างคำตอบธรรมชาติ ด้านการวัด การสแกนของเราอ่านคำตอบผ่านอินเทอร์เฟซโปรแกรมซึ่งไม่มีหน่วยโฆษณาสำหรับผู้บริโภค ค่าที่วัดได้จึงเป็นการมองเห็นแบบออร์แกนิกโดยโครงสร้าง (โดยการออกแบบ) หากแพลตฟอร์มใดเปิดให้วัดตำแหน่งที่จ่ายเงิน เราจะรายงานเป็นคอลัมน์แยกและไม่ผสมกับค่าออร์แกนิก (แผนงาน) ปัจจุบันรายงานมีเฉพาะการมองเห็นแบบออร์แกนิก และระบุไว้ชัดเจน
ความแม่นยำของคำตอบคืออะไร ทำไมจึงสำคัญ?
ความแม่นยำของคำตอบเปรียบเทียบสิ่งที่ AI บอกลูกค้าของคุณจริงกับคำตอบมาตรฐานที่ตรวจสอบแล้ว เมื่อ AI ให้ข้อมูลสินค้าผิด ลิงก์ล้าสมัย หรือข้อมูลติดต่อผิด ลูกค้าทำตามและทีมซัพพอร์ตของคุณเป็นผู้จ่าย MemeCMO ทำเครื่องหมายคำตอบที่ไม่ถูกต้องแต่ละข้อรายengine เพื่อให้คุณแก้จากต้นทาง
ครอบคลุม AI engine และตลาดใดบ้าง?
ChatGPT, Gemini, Perplexity, Claude และหน้า Google AI Overview จริง ระบุตำแหน่งตามพื้นที่ ตลาด: เวียดนาม ไทย อินโดนีเซีย มาเลเซีย สิงคโปร์ และฟิลิปปินส์ในภาษาท้องถิ่น และสหรัฐฯ รายรัฐ (ระดับ 1: แคลิฟอร์เนีย เท็กซัส ฟลอริดา นิวยอร์ก) พร้อมกรอบกฎระเบียบรัฐสำหรับอุตสาหกรรมที่กำกับดูแล
คิดราคาอย่างไร?
แพ็กเกจรายเดือนต่อแบรนด์ × ตลาดกำหนดจังหวะสแกน ขนาดคลังคำถาม engine และรายงาน สแกนตามกำหนดและรายงานรวมอยู่แล้ว เครดิตครอบคลุมสแกนตามต้องการและการรันเนื้อหาเพิ่มเติม พาร์ทเนอร์เอเจนซี่ได้ workspace ต่อลูกค้า รายงานรวม ไม่จำกัดผู้ใช้ และราคาขายส่ง
MemeCMO เหมาะกับใคร?
แบรนด์ที่เข้าสู่เอเชียตะวันออกเฉียงใต้ — โดยเฉพาะบริษัทจีนที่ออกสู่ตลาดโลก — แบรนด์ภูมิภาคที่ปกป้องตลาดบ้าน แบรนด์สหรัฐฯ ในอุตสาหกรรมกำกับดูแลที่คำตอบต่างกันตามรัฐ และเอเจนซี่กับกลุ่มสื่อที่ให้บริการพวกเขาในฐานะพาร์ทเนอร์ช่องทาง
MemeCMO ต่างจาก Semrush, Profound หรือเครื่องมือ GEO อื่นอย่างไร?
เครื่องมือ GEO ส่วนใหญ่หยุดอยู่ที่แดชบอร์ด MemeCMO ไปไกลกว่านั้นอีกสามขั้น สิบ agent ของ MemeCMO ผลิตงานส่งมอบ — คำตอบมาตรฐาน, JSON-LD, เนื้อหาปิดช่องว่าง, การเผยแพร่บนสื่อภายนอก, ร่างสารานุกรม — จากข้อเท็จจริงที่เปิดเผยต่อสาธารณะของคุณเท่านั้น การวิเคราะห์ไปไกลกว่าคะแนน: จัดกลุ่ม engine ตามว่าอ่านเว็บหรือไม่ ดึงหน้าที่ถูกอ้างอิงมาวิเคราะห์ลักษณะ ตรวจคำตอบของ AI เทียบกับเว็บไซต์ของคุณเอง และวัดทุกการดำเนินการเทียบกับคำถามที่คุณไม่ได้แตะ และทุกตัวเลขเป็นไปตามมาตรฐานการวัดผลสาธารณะ ทั้งในภาษาเอเชียตะวันออกเฉียงใต้และสหรัฐฯ รายรัฐ ตารางเปรียบเทียบฉบับเต็มพร้อมแหล่งอ้างอิง →
ติดต่อ

บรรทัดแรกของแบรนด์คุณในบทสนทนากับ AI —
คุณเป็นผู้กำหนดว่ามันจะพูดอะไร

ขอเข้าใช้แพลตฟอร์มหรือคุยเรื่องพาร์ทเนอร์ บอกเราถึงแบรนด์และตลาด เราจะรันสแกนฐานและพาคุณอ่านผล

EMAIL
สำนักงานใหญ่
ฮ่องกง · ดำเนินงานทั่วเอเชียตะวันออกเฉียงใต้และสหรัฐฯ

ขอเข้าใช้งาน

เราตอบกลับภายใน 24 ชั่วโมง