Gawing sagot ng AI ang iyong brand.

Tingnan kung ano ang sinasabi ng ChatGPT, Gemini, Perplexity, Claude at Google AI Overview sa iyong mga mamimili — at kung aling mga source ang binabasa nila bago sumagot.

Libreng preview scan · totoong sagot mula sa ChatGPT at Google AI Overview · walang credit card
Sinusukat sa limang AI engine
ChatGPT Gemini Perplexity Claude Google AI Overview

Halimbawa mula sa Vietnam, ang unang market na inilalathala namin · Hindi pa nailalathala ang listahan para sa Pilipinas

1,992na sagot ng AI na may citation ang binasa namin sa Vietnam noong Setyembre, mula sa 10 brand panel sa 6 na industriya.Setyembre 2026 · 4 na engine
0.7%ng binabasa ng AI ay galing sa sariling website ng brand, kapag hindi pa kilala ng mamimili ang brand.12 brand · 3,011 sagot na may citation · Hunyo–Oktubre 2026
19.2%ng mga sagot na may citation ang bumabanggit sa vnexpress.net — ang source na pinakaaasahan ng AI sa Vietnam.382 sa 1,992 · Setyembre 2026
MemeCMO — hindi namin hinuhulaan kung ano ang sinasabi ng AI tungkol sa iyo. Sinusukat namin ito, inaayos, at pinapatunayang may gumalaw.
Limang engine · sampung agent · isang pampublikong pamantayan sa pagsukat
SUKATIN · LIMANG ENGINE · ISANG FROZEN PANEL

Itanong sa AI ang itinatanong ng iyong mga mamimili. Bawat linggo, parehong mga tanong.

Sa bawat scan, itinatanong namin ang mga tanong na talagang itinatanong ng iyong mga mamimili — sa sarili nilang wika, sa bawat yugto ng pagbili — sa ChatGPT, Gemini, Perplexity, Claude at sa live na Google AI Overview page. Hindi nagbabago ang panel, kaya ang pagbabago sa score ay pagbabago sa AI, hindi sa test.

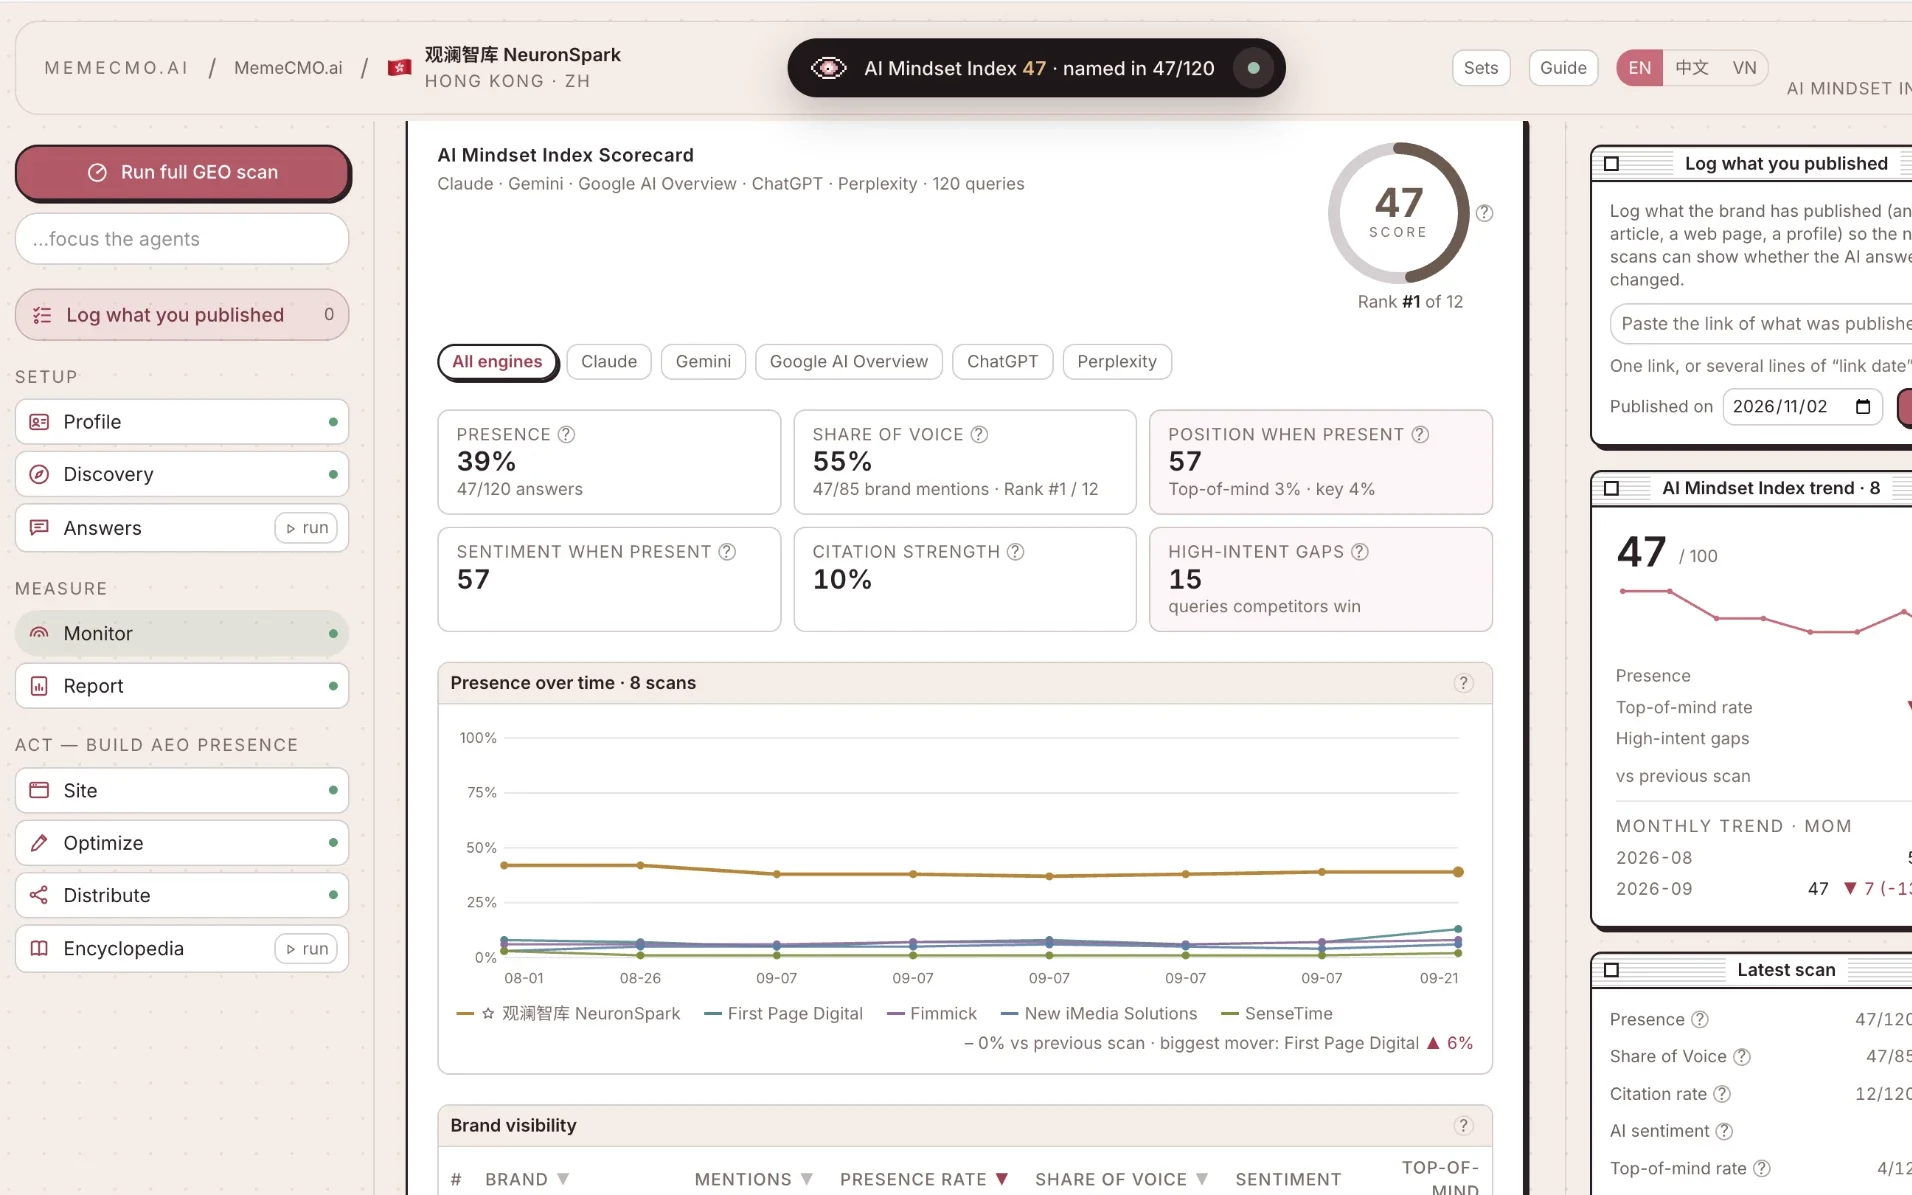
  • Presence, share of voice, prominence, sentiment at citation — bawat rate ay may kasamang numerator at denominator
  • Bawat engine nang hiwalay: ang parehong brand ay maaaring nangunguna sa isa at wala sa susunod
  • Bawat numero ay nagbubukas ng buong sagot sa likod nito at ng mga pahinang sini-cite ng engine
app.memecmo.ai
MemeCMO monitor dashboard: presence sa paglipas ng panahon, brand visibility table, presence bawat engine
MGA SOURCE · SAAN TUMITINGIN ANG AI

Binabasa namin ang mga pahinang binabasa ng AI.

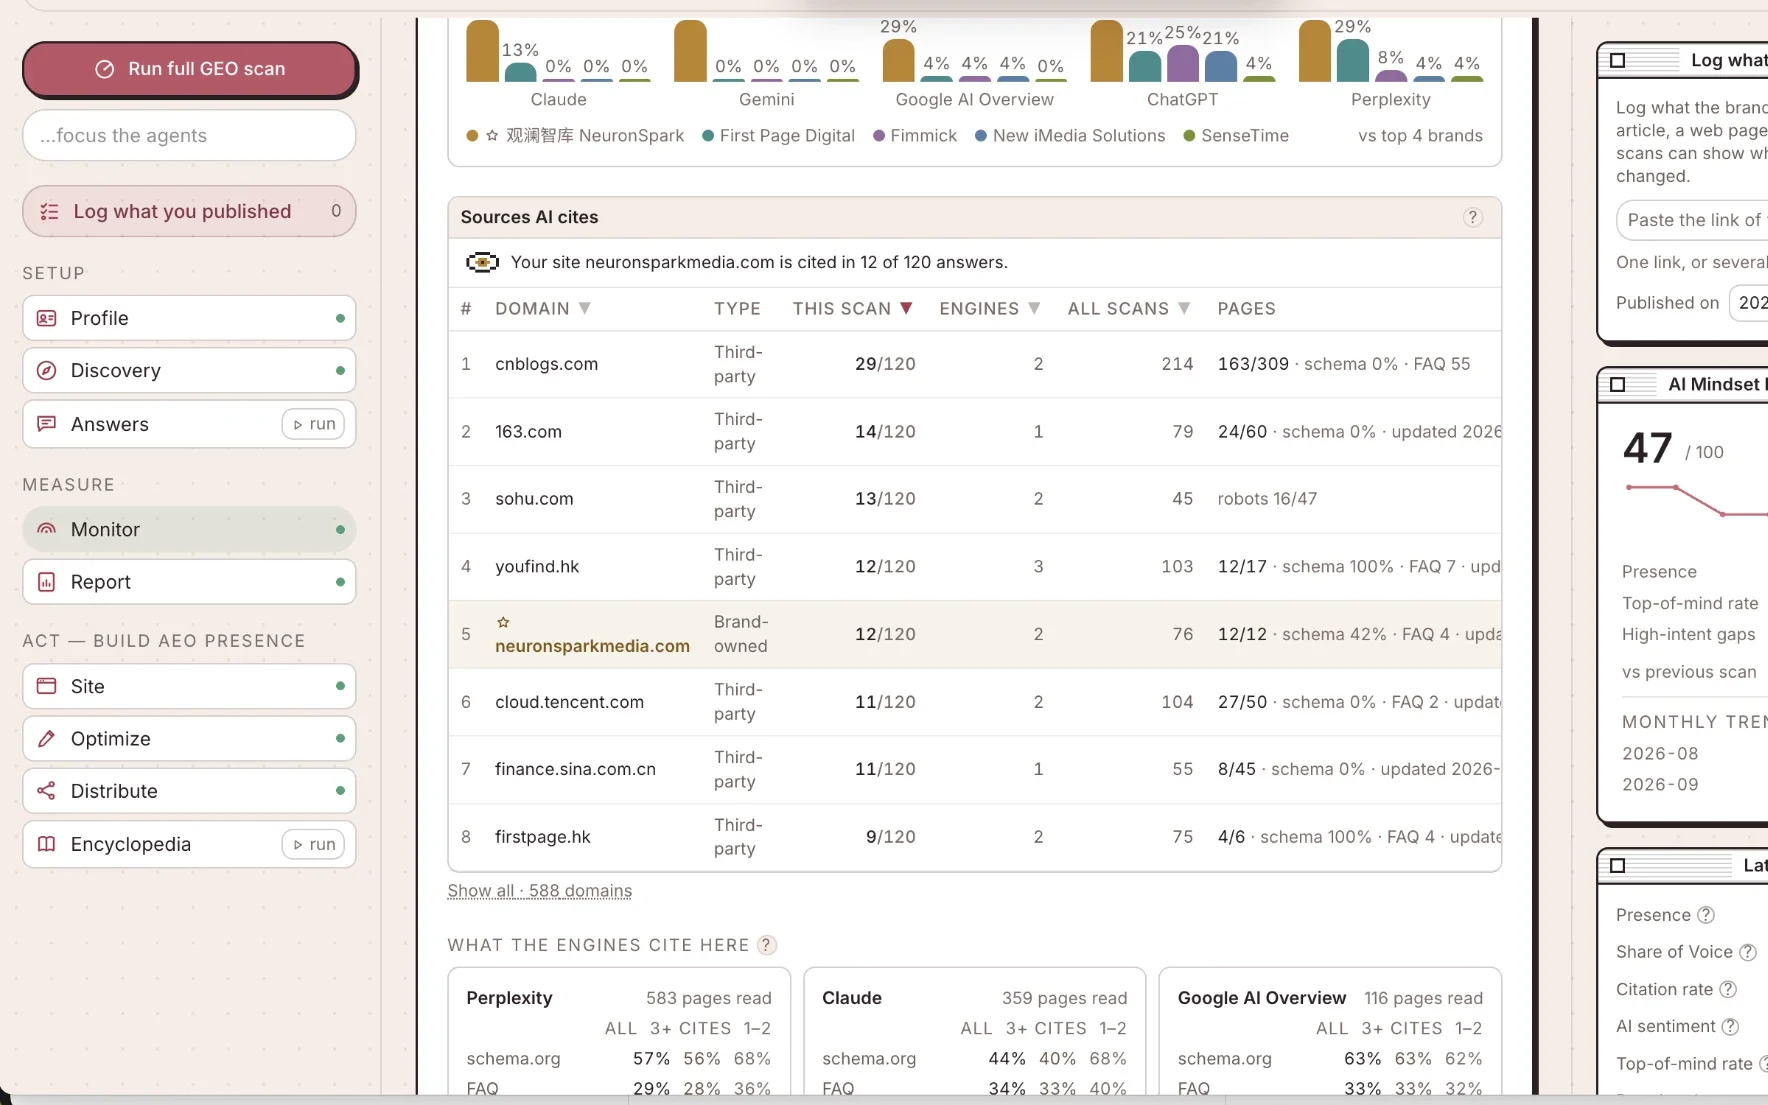
Sa bawat merkado, umaasa ang mga engine sa maikling listahan ng mga site. Niraranggo namin ang mga ito sa bawat scan, kinukuha ang mga pahinang sini-cite nila at sinusuri ang mga ito — structure, freshness, schema, haba — para ang “kung ano ang nasi-cite” ay maging pamantayang sinusundan ng iyong content, hindi hula.

  • Ang mga domain na inaasahan ng bawat engine sa iyong merkado, niraranggo sa bawat scan
  • Ang pagkakapareho ng mga na-cite na pahina, bawat engine at ayon sa dalas ng pag-cite sa kanila
  • Isang pampublikong buwanang listahan ng mga source na sini-cite ng AI sa Vietnam, malayang magamit muli (CC BY 4.0)
Mga source na sini-cite ng AI sa Vietnam →
app.memecmo.ai
Mga source na sini-cite ng mga AI engine, kasama ang page features bawat domain
KUMILOS · SAMPUNG AGENT · MGA DELIVERABLE

Sampung agent ang naghahatid ng mga sagot na kulang.

Standard answers, page edits, paste-in schema, gap content, placement kits at encyclopedia drafts — sa wika ng mamimili, isinulat ayon sa citation profile ng iyong merkado, mula sa mga fact na pampubliko na sa iyong site. Ang numerong walang source ay nagiging blangkong pupunan mo, hindi kailanman inimbento.

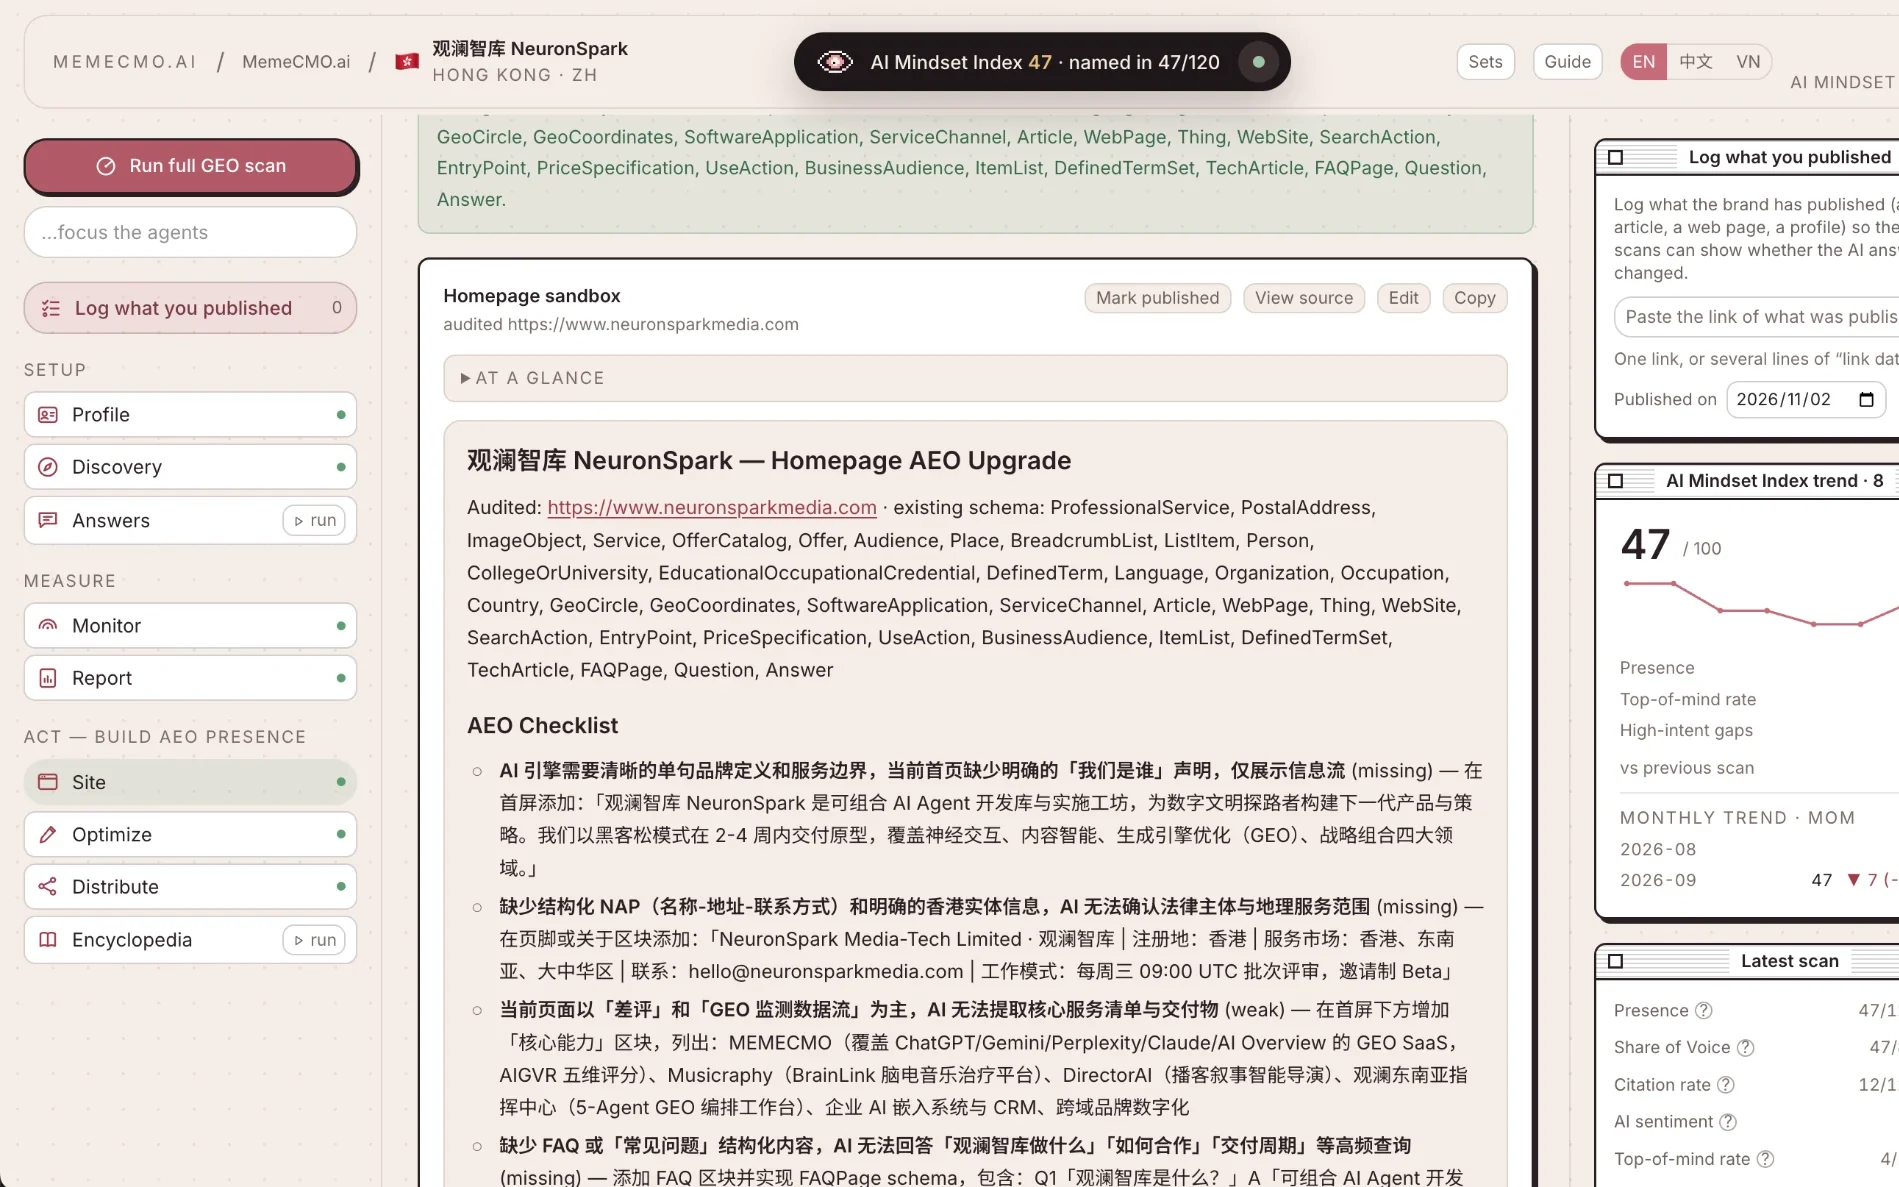
  • Mag-dispatch ng agent sa kaliwa, mag-review sa stage, panoorin ang live activity sa kanan
  • Bawat draft ay nakabatay sa kung ano talaga ang sini-cite ng mga engine sa iyong merkado
  • Ang in-edit ng iyong team ay nananatiling edited — iginagalang ito ng bawat re-run
app.memecmo.ai
MemeCMO workspace na may card-style na deliverables at live activity panel
PATUNAYAN · BAGO AT PAGKATAPOS

Patunay, hindi pakiramdam.

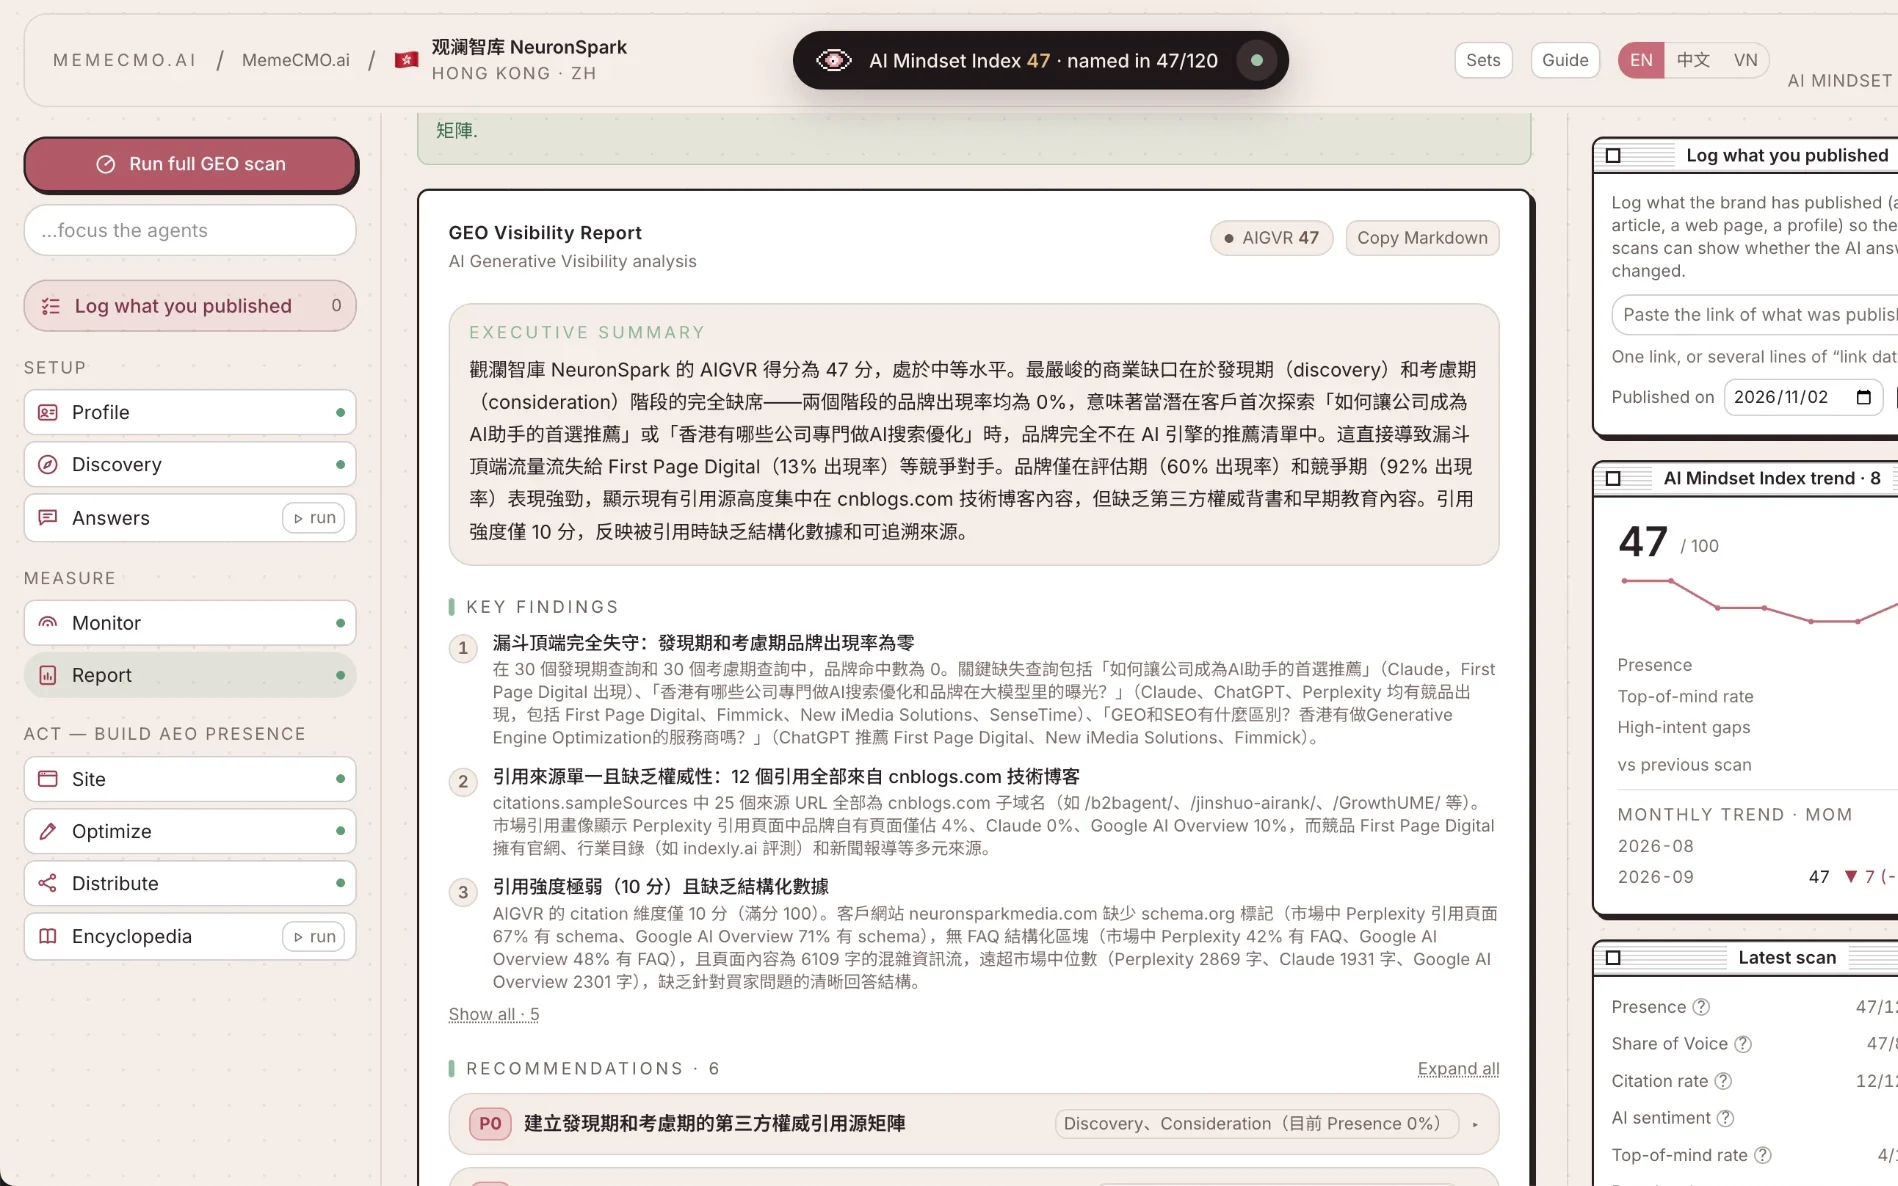
I-log kung ano ang naging live. Kinukuha namin ang pahina, kinukuhanan ito ng fingerprint at binabantayan kung sinisimulan itong gamitin ng mga engine. Ipinapakita ng mga susunod na scan kung ano ang gumalaw — bawat tanong at bawat engine — katabi ng mga tanong na hindi mo ginalaw.

  • Bawat na-log na aksyon ay vine-verify na live, at sinusubaybayan ang mga pagbabago nito sa paglipas ng panahon
  • Before/after bawat tanong at engine, kasama ang site coverage at contradictions sa bawat report
  • Isang pampublikong pamantayan sa pagsukat (v1.1) sa likod ng bawat numerong inilalathala namin
Basahin ang pamantayan sa pagsukat →
app.memecmo.ai
MemeCMO report na may naka-collapse na recommendations, site coverage at verified actions
Buksan ang live demo →
Totoong brand, totoong sinukat — lingguhang refresh, walang sign-up.
ANG MGA ENGINE

Tatlong uri ng sagot ng AI.
Tatlong magkaibang paraan para baguhin ito.

Hindi lahat ng engine ay nagbabasa ng web. Inuuri namin ang bawat isa ayon sa ipinapakita mismo ng scan — ilan sa mga sagot nito ang may kasamang source — dahil iba-iba ang nagpapagalaw sa kanila.

01
PerplexityGoogle AI Overview

Nagbabasa ng web, at ng iyong site

Binubuo ang mga sagot mula sa mga pahinang kinukuha nang live, kasama ang sa iyo. Ang sarili mong mga pahina, structured data at freshness ang unang nakapagpapagalaw sa mga ito.

Pagtuunan: ang iyong site, at ang mga pahinang ikinukumpara rito
02
Claude

Nagbabasa ng web, bihira ang iyong site

Naghahanap muna bago sumagot, pero sa aming mga scan, mas malaki ang pag-asa nito sa mga encyclopedia, balita at directory kaysa sa mga site ng brand.

Pagtuunan: mga pinagkakatiwalaang third-party na pahina na naglalaman ng iyong mga fact
03
ChatGPTGemini

Sumasagot mula sa training

Sumasagot mula sa natutunan na ng model. Gumagalaw ito ayon sa kung ano ang malawak at tuloy-tuloy na nailalathala tungkol sa iyo — ang pinakamabagal na paraan, at ang pinakamatagal ang epekto.

Pagtuunan: parehong mga fact, nailalathala nang malawak at tuloy-tuloy

Nagmumula ang mga uri sa bawat scan, hindi sa nakapirming listahan: kapag binago ng isang engine kung paano ito sumasagot, nagbabago rin ang uri nito.

ANG PAGSUSURI

Anim na pagsusuri sa likod ng bawat report.

Ang visibility score ay simula pa lang ng trabaho. Ito ang mga pagsusuring nagsasabi kung ano ang susunod na gagawin — at kung gumana ito.

01

Kung saan nagbabasa ang AI, sa bawat yugto

Hinahati namin ang bawat tanong ayon sa yugto ng mamimili. Bago makilala ng mamimili ang isang brand, 0.7% lang ng binabasa ng AI ang sariling site nito (12 brand, 3,011 sagot na may citation sa Vietnam). Kaya ipinapakita namin kung aling mga third-party na pahina ang nagpapasya sa unang sagot — at nagpaplano kami para sa mga ito.

02

Ang mga na-cite na pahina, binuksan at sinukat

Kinukuha namin ang mga pahinang sini-cite ng bawat engine at sinusuri ang structure, freshness, schema at haba. Nagkakaroon ang iyong content ng nasukat na pamantayang dapat abutin sa halip na isang style guide.

03

Ang iyong site laban sa sinasabi ng AI

Binabasa namin ang iyong mga pampublikong pahina at itinatabi sa mga sagot: kung saan sinasalungat ka ng AI, kung saan wala itong sinasabi, kung saan nilalaktawan nito ang inilalathala mo. Sa source napupunta ang pag-aayos — sa iyong site — hindi sa aming database.

04

Bago at pagkatapos, laban sa isang control

Bawat aksyong ini-log mo ay may petsa at vine-verify nang live. Ang galaw sa mga tanong na tinarget nito ay ikinukumpara sa mga tanong na hindi mo ginalaw, sa parehong frozen panel; ang mga pagtaas lang na higit sa 10 puntos sa itaas ng control ang binibilang.

05

Isang scoring model na sinusuri laban sa human labels

Isang model ang nag-i-score sa mga sagot, at sinusuri ang model na iyon laban sa blind human labels sa bawat wika. Ginagamit lang ang bagong scoring model kapag tumutugma ito sa mga iyon.

06

Ang bigong sagot ay hindi kailanman “hindi nabanggit”

Kapag hindi sumagot ang isang engine o hindi nag-load ang isang pahina, minamarkahang bigo ang sagot — hindi kailanman binibilang na wala ang iyong brand — at nakasaad sa bawat report ang coverage nito.

SAMPUNG AGENT

Sampung agent.
Bawat isa ay nag-iiwan ng deliverable.

Tuklasin kung ano ang tinatanong ng mga mamimili → sukatin ang sagot ng AI → buuin ang kulang mula sa sarili mong mga fact → i-log kung ano ang naging live → sukatin muli sa parehong panel.

01

Profile · Discovery · Standard Answers

Isang fact base na binuo lamang mula sa iyong mga pampublikong pahina at dokumento; 110 tanong ng mamimili bawat merkado sa wika ng mamimili, 20 rito ang pangunahin; canonical answers na nakabatay sa mga fact na iyon.

02

Monitor

Limang engine, tunay na surfaces, isang frozen panel. Presence sa paglipas ng panahon, share of voice, bawat engine at bawat tanong — bawat cell ay nagbubukas ng sagot sa likod nito.

03

Report · Full Scan

Ano ang nagbago, bakit ito mahalaga, ano ang susunod na gagawin — may kalakip na ebidensya, at isang lingguhang digest na isinulat para sa yugtong kinaroroonan ng iyong brand. Pinapatakbo ng Full Scan ang Discovery → Monitor → Report sa isang takbo.

04

Site · Optimize

Paste-in JSON-LD at konkretong edits para sa sarili mong mga pahina; publish-ready na mga pahina at FAQs para sa mga tanong na napapanalunan ng mga kakumpitensya ngayon.

05

Distribute · Encyclopedia

Placement kits para sa mga source na sini-cite na ng AI sa iyong merkado, hindi kasama ang mga kakumpitensya, at encyclopedia drafts na may compliant na proseso.

memecmo.ai

Hindi dashboard —
kundi isang agent team na naghahatid.

Isang owner sa panig mo, sampung agent sa panig namin: nagbabasa, sumusukat, bumubuo at nagtatala sila, at ang iyong team ang nagre-review at nagpapasya. Walang kailangang i-hire na engineer sa panig mo.

PAKIKIPAGTRABAHO SA AMIN

Anim na pangako, nakapaloob sa serbisyo.

Ito ang maaari mong panghawakan sa amin. Bawat isa ay nakikita mo sa workspace, hindi linya sa isang slide.

01

Deliverables, hindi payo

Bawat agent ay naghahatid ng maaari mong i-publish: isang pahina, isang schema block, isang placement kit, isang encyclopedia draft. Ikaw ang nagre-review at nagpa-publish; hindi kami kailanman nagpo-post para sa iyo.

02

Mga fact mula lamang sa iyong site

Sumusulat lamang ang mga agent mula sa mga fact na pampubliko na sa iyong site at sa mga dokumentong ibinibigay mo sa amin. Ang numerong walang source ay nagiging blangkong pupunan mo.

03

Permanente ang iyong mga edit

Mag-re-tag ng kakumpitensya, baguhin ang wording ng isang tanong, ayusin ang isang pangungusap — itinatala ito kasama ang dahilan at muling inilalapat sa bawat re-run. Naiipon ang paghuhusga ng iyong team sa halip na mawala.

04

Isang digest bawat linggo, isang card na aaksyunan

Isang digest sa simpleng wika bawat linggo, at ang pinakamahalagang aksyon bilang card sa chat ng iyong team: kumpirmahin ito sa isang tap at papasok ito sa ledger para masukat.

05

Isang pamantayang masusuri mo

Bawat rate ay may numerator at denominator, na binigyang-kahulugan sa pampublikong Measurement Standard (v1.1). Nagkakaiba ang mga plan sa saklaw, hindi kailanman sa pamamaraan.

06

Walang ranking na ibinebenta, walang pangako tungkol sa AI

Hindi kami nagbebenta ng puwesto sa mga sagot ng AI o naggagarantiya kung ano ang sasabihin ng isang engine. Tapat kaming sumusukat, inilalathala namin ang aming mga listahan ng source at nakikipagtulungan kami sa media na binabasa na ng AI.

MGA MERKADO

Timog-Silangang Asya, anim na merkado.
Estados Unidos, bawat estado.

Ang isang project ay isang brand × isang merkado. Sa Timog-Silangang Asya, halos walang laman ang AI knowledge layer sa mga lokal na wika; sa US, binabago ng batas ng estado ang tamang sagot — kaya bawat estado ay sariling merkado.

🇻🇳
Vietnam
Tiếng Việt
ChatGPT 8M+ MAU. Halos zero ang GEO competition. Ang aming flagship market.
🇹🇭
Thailand
ภาษาไทย
Kasisimula pa lang ng Thai-language AI ecosystem — bukas na bukas ang brand window.
🇮🇩
Indonesia
Bahasa Indonesia
270M tao, pinakamalaking merkado ng rehiyon — nangunguna sa AI adoption sa Timog-Silangang Asya.
🇲🇾
Malaysia
Bahasa Melayu
Malay / English / Chinese crossroads — kailangan ng GEO ng tri-lingual na koordinasyon.
🇺🇸
Estados Unidos
Bawat estado · us.memecmo.ai
50 estado, Tier-1 CA · TX · FL · NY. Mga regulated vertical kung saan binabago ng batas ng estado ang sagot: legal, insurance, healthcare, home services, solar.

Bakit ang mga merkadong ito?

Red ocean na ang English-language AI cognition para sa global brands. Sa Vietnamese, Thai, Indonesian, Malay at Filipino, halos bakante pa ang AI knowledge layer — ang mga nauuna ang sumusulat ng default na sagot. At sa Estados Unidos, nagtatanong ang mga mamimili sa AI na may kasamang estado ("best injury lawyer in Texas"), at magkaiba ang tama at compliant na sagot sa hangganan ng estado — itinatago ng national score kung saan ka talaga nananalo o natatalo.

PAANO TUMATAKBO

Baseline. Bumuo. Sukatin muli — bawat linggo.

Tumatakbo ang scans ayon sa iskedyul bilang bahagi ng serbisyo; bumubuo ang mga agent sa pagitan; dumarating ang digest sa iyong inbox tuwing Martes.

ARAW 0 · BASELINE

Full scan

Binubuo ng Discovery ang iyong prompt library; sinusukat ng Monitor ang limang engine; inuuna ng Report ang mga gap. Ang iyong baseline sa halos apat na minuto.

LINGGO 1–4 · BUMUO

I-deliver ang mga asset

Standard answers, JSON-LD schema, gap content, third-party placements, encyclopedia entries — bawat isa ay publish-ready deliverable, bawat isa ay bine-verify mo bago ilabas.

BAWAT LINGGO · SUKATIN MULI

Digest, report, ayusin

Pinapanatiling maikukumpara ang scores ng scheduled scans sa frozen prompt panel. Lingguhang digest, buwanang report, alerts sa pagbaba. Kailangan ng scan ngayon? Sagot ng credits ang on-demand runs.

FAQ · MGA SAGOT

Mga tanong, nasagot.

Ang mga sagot na pinakamadalas naming ibigay — isinulat para malinis ding ma-quote ng mga AI engine. Ang mga item 4 hanggang 7 ay nagmamarka ng bawat pangungusap: nasukat = datos na maaaring ulitin; sa disenyo = tinitiyak ng pagkakabuo ng sistema; dokumento ng vendor = sariling pahina ng platform; roadmap = wala pa, hindi pangako.

Ano ang GEO (Generative Engine Optimization)?
Ang GEO ay ang praktika ng pag-optimize kung paano kinakatawan ang isang brand sa loob ng mga generative AI engine tulad ng ChatGPT, Gemini, Perplexity, Claude at Google AI Overview. Kung ang SEO ay nakatuon sa ranked list ng mga link, ang GEO ay nakatuon sa sagot mismo — nababanggit ba ang iyong brand, gaano kalinaw, gaano katumpak, at aling mga source ang sini-cite ng engine.
Paano naiiba ang GEO sa SEO?
Ino-optimize ng SEO ang ranking sa listahan ng blue links; ino-optimize ng GEO ang pagsama, katumpakan at prominence sa loob ng generated na sagot. Magkaiba ang mga lever: structured data, authoritative third-party citations, canonical answers sa mga tanong ng mamimili, at content na isinulat para ma-quote — hindi backlinks at keyword density.
Ano ang sinusukat ng MemeCMO?
Standard metrics bawat engine: presence (gaano kadalas kang nababanggit), share of voice (iyong bahagi sa lahat ng brand mentions), citation rate (gaano kadalas na-cite ang mga source na pabor sa iyo), AI sentiment, top-of-mind rate (gaano kadalas kang unang napapangalanan), at answer accuracy (tugma ba ang product facts at links ng AI sa iyong verified standard answers). Ang weighted AI Mindset Index ang nagbubuod sa kanila; ang metrics ang ground truth.
Magkaiba ang memory at personalization ng bawat AI account. Bakit mapagkakatiwalaan ang scan data?
Sa isang linya: nagtatanong ang scan sa malinis na session nang walang memory ng sinumang account, kaya ang reading ay sahig na hindi kailanman pinalalaki. Walang account ng sinuman ang ginagamit sa scan. Bawat tanong ay ipinapadala sa engine sa pamamagitan ng programming interface nito sa isang malinis na session: walang chat history, walang memory, walang personalization, temperature 0, naka-lock ang bawat salita ng tanong; bawat scan ay nagtatanong ng 24 na tanong sa 5 engine sa nakatakdang ritmo, at iniimbak ang buong sagot at mga pinagmulang binanggit (sa disenyo). Ang isang reading ay kumakatawan sa isang user na walang history na unang beses nagtatanong ng tanong na iyon sa lokal na wika, ang baseline na pinagmumulan ng bawat personalized na sagot (sa disenyo). Paulit-ulit na scan sa iisang araw: ang mga engine na sumasagot mula sa training memory (ChatGPT, Gemini) ay nagbabago ng 0 hanggang 1 sa 24 na tanong, ang mga engine na nagbabasa ng web (Claude, Perplexity, Google AI Overview) ay nagbabago ng 0 hanggang 4 sa 24, at ang kabuuang score ay gumagalaw ng 1 hanggang 5 puntos sa loob ng isang araw, at ang galaw ay nasa mga engine na nakabatay sa paghahanap (nasukat, 11 pag-uulit sa dalawang panel, Hulyo hanggang Nobyembre 2026). Inilagay din namin ang parehong 20 tanong sa ChatGPT web app nang hindi naka-log in: ang 10 tanong na may brand ay 10/10 sa magkabilang panig; sa 10 tanong na walang brand, ang web app na naghahanap sa web ay nagbanggit ng brand ng 5 beses laban sa 1 sa reading ng interface, at hindi kailanman kabaligtaran. Ang reading ng malinis na session ay sahig, hindi kailanman pinalalaki (nasukat, 2 Nobyembre 2026). Pinatakbo rin namin ang parehong 20 tanong sa apat na naka-log-in na account ng founder na nakabukas ang memory: 10/10 ang 10 tanong na may brand sa lahat ng apat; sa 10 tanong na walang brand, tig-4 na beses binanggit ng Gemini, Claude at Perplexity ang brand, kapantay ng 1 hanggang 4 ng programming interface, at iisang tanong na walang brand ang binanggit ng interface ngunit hindi ng alinman sa tatlong account na iyon; 10/10 ang naka-log-in na ChatGPT dahil dinala ng memory ng account ang brand na naunang itinanong sa bawat susunod na sagot; nang patakbuhin muli ang parehong account nang naka-off ang memory, bumaba sa 3/10 ang mga tanong na walang brand, balik sa saklaw ng programming interface (nasukat, 2 Nobyembre 2026). Tanging ang mga naka-iskedyul na scan ang pumapasok sa trend, ang manual na scan ay spot check lamang; ang pagpapalit ng model ng engine at ang mga nabigong fetch ay naitatala bawat sagot at minamarkahan sa report (sa disenyo).
Anong AIGVR score o presence rate ang maituturing na maganda?
Sa isang linya: walang passing mark; tatlong panukat, at ang pagkabanggit sa mga tanong tungkol sa kategorya ang tunay na bilang. Walang pangkalahatang passing mark; nagbibigay ang report ng tatlong panukat nang magkatabi (sa disenyo). Una, laban sa sarili mong Day-0 baseline: ang mga target sa kontrata ay nakasulat bilang pagbuti kumpara sa unang reading. Pangalawa, laban sa mga kakumpitensyang sinukat sa parehong scan: ang share of voice ay gumagamit ng bawat nabanggit na brand bilang denominator at nagkakabuo ng 100%, kaya malinaw kung sino ang inirerekomenda ng AI. Pangatlo, pinaghihiwalay ang mga tanong na may brand at ang mga tanong tungkol lang sa kategorya: sa bawat panel na nasukat namin, ang presence kapag tinipa ng user ang pangalan mo ay halos laging malapit sa 100% at kaunti lang ang pinatutunayan; ang tunay na larangan ay kung nababanggit ka kapag kategorya lang ang tinatanong, isang rate na karaniwang nasa isa hanggang dalawa sa sampu at doon ang puwang ng paglago (nasukat). Ang mga industry benchmark ay inilalathala lamang kapag lima o higit pang kliyente ang nasa iisang kategorya, kaya sa ngayon ang benchmark ay ang mga kakumpitensya mo sa iyong merkado (sa disenyo). Bawat rate ay nagpapakita ng numerator at denominator nito (sa disenyo).
Kung tumaas ang mga numero, paano namin malalaman na GEO ang dahilan at hindi PR, advertising, o ang sariling pagbabago-bago ng AI?
Sa isang linya: itala, beripikahin, mga control na tanong, hiwalay na markahan ang mga pagbabago ng engine; ang neto na epekto ay mabibilang lamang sa itaas ng noise ceiling. Apat na paraan, magkakapatong (sa disenyo). Isa, bawat paglalathala ay naitatala bilang aksyon: URL, petsa, channel, at ang mga tanong na tinatarget; kinukuha ng platform ang pahina at bineberipika na live ito. Dalawa, pagkatapos ng susunod na naka-iskedyul na scan, ipinapakita ng report ang reading bago at pagkatapos, bawat tinarget na tanong at bawat engine; ang mga tanong na walang nagtarget ang nagsisilbing control, at doon lumilitaw ang sariling pagbabago-bago ng platform. Tatlo, ang mga pagbabago sa panig ng engine (pagpapalit ng model, paglipat sa web search) ay nahuhuli ng pang-araw-araw na patrol, minamarkahan sa report bilang pagbabago ng pamamaraan at itinuturing na bagong baseline, hindi kailanman ikinakredito sa anumang aksyon. Apat, ang pinakadirektang ebidensya ay ang citation: kapag binanggit ng engine ang piyesang itinala mo, hindi na kailangan ng paghihinuha ang attribution. Isang beses na naming kinalkula ito sa panel ng isang kliyente: matapos maglathala ang site ng mga artikulong pinangalanan tulad ng 8 sa mga pangunahing tanong nito, ang presence sa 8 tanong na iyon ay tumaas nang neto ng 37 puntos sa engine na nagbabasa ng web (pagkabawas ng galaw ng 12 control na tanong) at 0 sa mga engine na nakabatay sa training; 2,000 placebo draw ng random na control na tanong ang naglagay ng noise ceiling ng mga engine na nakabatay sa paghahanap sa humigit-kumulang 17 puntos, na dapat lampasan ng neto na epekto upang mabilang (nasukat, Agosto hanggang Setyembre 2026). Sa isang nakapirming panel, hindi gumalaw ang kabuuang presence ng mga engine na nakabatay sa training sa loob ng 12 linggo; ang gumagalaw ay ang mga engine na nakabatay sa paghahanap (nasukat). Tungkol sa PR at advertising: walang nakikitang screen o placement ang mga AI engine, mga web page lamang, kaya sa mga pahina ng coverage lang sila makakapasok sa sagot, at ang pagtatala ayon sa channel ang naghihiwalay sa kanila (sa disenyo). Ang netong bilang na treated minus control ay kinakalkula nang mano-mano ngayon; ang awtomatikong paglalagay nito sa report ay nasa roadmap (roadmap).
Nagsisimula nang magbenta ng ads ang mga AI platform. Kailangan pa ba ang GEO?
Sa isang linya: binibili ng bayad na slot ang puwang sa tabi ng sagot, ang GEO ay gumagana sa mismong sagot; ang aming reading ay naglalaman lamang ng organic visibility. Oo, at lalo pa kapag lumitaw ang mga bayad na slot. Ang kasalukuyang kalagayan: sinusubukan ng ChatGPT ang mga sponsored slot sa ilalim ng mga sagot para sa mga user ng Free at Go sa US mula Pebrero 2026, at sinabi ng OpenAI na hindi nito naiimpluwensyahan ang sagot; ang mga ad sa Google AI Overviews ay live na sa 12 bansang nagsasalita ng Ingles (kabilang ang Indonesia, Malaysia, Pilipinas at Singapore, hindi kasama ang Vietnam o Thailand), nang walang opt-out at walang targeting para sa mga advertiser; umatras ang Perplexity sa advertising noong Pebrero 2026; nangako ang Claude na mananatiling walang ad; wala pang ad ang Gemini app (dokumento ng vendor, hanggang Nobyembre 2026). Ang bayad na slot ay nakalabel na sponsored content, sinisingil bawat impression, nawawala kapag tumigil ang budget, at hindi nito binabago kung sino ang inirerekomenda o binabanggit ng AI sa katawan ng sagot nito (dokumento ng vendor at sa disenyo). Sa katawang iyon gumagana ang GEO: ang mabanggit, mailarawan nang tama at ma-cite, naiipon sa ilang engine at hindi nakadepende sa gastos. Pareho ang relasyon sa SEO at SEM sa search; ang mga bayad na slot ay ibinebenta sa tabi ng organic na sagot. Sa pagsukat, binabasa ng aming scan ang mga sagot sa pamamagitan ng programming interface ng mga engine, na walang mga ad unit para sa consumer, kaya ang aming reading ay organic visibility ayon sa pagkakabuo (sa disenyo); kung sakaling ibukas ng isang platform ang mga bayad na placement para masukat, iuulat namin ito bilang hiwalay na column at hindi kailanman ihahalo sa organic na reading (roadmap). Sa ngayon ang report ay naglalaman lamang ng organic visibility, at sinasabi iyon.
Ano ang Answer Accuracy at bakit mahalaga?
Ikinukumpara ng Answer Accuracy ang aktwal na sinasabi ng AI sa iyong mga customer sa iyong verified standard answers. Kapag maling product facts, lumang link o maling contact details ang ibinigay ng AI, kikilos ang customer ayon dito at ang support team mo ang magbabayad. Minamarkahan ng MemeCMO ang bawat maling sagot bawat engine para maayos mo ang source.
Aling mga AI engine at merkado ang sakop?
ChatGPT, Gemini, Perplexity, Claude at ang tunay na Google AI Overview page, location-targeted. Mga merkado: Vietnam, Thailand, Indonesia, Malaysia, Singapore at Pilipinas sa kanilang lokal na wika, at Estados Unidos bawat estado (Tier-1: California, Texas, Florida, New York) na may state regulatory frames para sa regulated verticals.
Paano ang pricing?
Itinatakda ng buwanang plan bawat brand × merkado ang scan cadence, laki ng prompt library, engines at reports; kasama na ang scheduled scans at reports. Sagot ng credits ang on-demand scans at dagdag na content runs. May workspace bawat kliyente, rollup reports, walang limitasyong seats at wholesale pricing ang mga agency partner.
Para kanino ang MemeCMO?
Mga brand na papasok sa Timog-Silangang Asya — lalo na ang mga kumpanyang Tsino na nagpapalawak — mga regional brand na nagtatanggol ng home market, mga US brand sa regulated verticals kung saan nag-iiba ang sagot bawat estado, at ang mga agency at media group na naglilingkod sa kanila bilang channel partners.
Paano naiiba ang MemeCMO sa Semrush, Profound o ibang GEO tools?
Karamihan ng GEO tools ay humihinto sa dashboard. Lumalampas pa ng tatlong hakbang ang MemeCMO. Ang sampung agent nito ang gumagawa ng deliverables — standard answers, JSON-LD, gap content, placements, encyclopedia drafts — mula lamang sa iyong mga pampublikong fact. Lumalampas sa score ang pagsusuri nito: inuuri ang mga engine ayon sa kung nagbabasa sila ng web, kinukuha at sinusuri ang mga na-cite na pahina, ikinukumpara ang mga sagot ng AI sa sarili mong site, at sinusukat ang bawat aksyon laban sa mga tanong na hindi mo ginalaw. At bawat numero ay sumusunod sa isang pampublikong pamantayan sa pagsukat, sa mga wika ng Timog-Silangang Asya at sa US bawat estado. Kumpletong paghahambing na may mga source →
KONTAK

Ang unang linya ng iyong brand sa usapan ng AI —
ikaw ang magpapasya kung ano ang sasabihin nito.

Humiling ng platform access o ng usapang partner. Sabihin sa amin ang brand at merkado; patatakbuhin namin ang baseline scan at gagabayan ka sa mga resulta.

EMAIL
PUNONG-TANGGAPAN
Hong Kong · nag-o-operate sa buong Timog-Silangang Asya at Estados Unidos

Humiling ng access

Sumasagot kami sa loob ng 24 oras.